从 GitHub 学习到可检索知识库
一个常见的场景是:在 GitHub Trending 上看到一个有意思的仓库,收藏进列表,过两周再打开时只剩下一个名字。当时为什么看、读到哪一层、结论是否验证过,全凭记忆。有些结论写进了博客,有些留在私有笔记,还有一些只出现在某次对话里。等到在手机上想问「之前研究过的那个会话恢复机制到底怎么做的」,得到的往往是一句含糊的「好像看过」。
工具并不少。代码托管、笔记软件、博客框架、手机助手都不缺,缺的是一条把学习变成可发布、可检索、可追溯的链路。本文讨论怎样利用已有的学习 CLI、Hexo 博客和 AI 导出插件,把一项 GitHub 仓库研究从私有原稿送到公开文章,再变成手机端可以检索的知识,以及在哪些环节必须停下来。
范围先说清楚。本文不设计新的笔记应用,也不把所有材料塞进向量数据库。它处理三个场景:学习过程要能恢复,换机器、换 Agent 仍知道依据哪个 commit、哪条证据、哪一版报告;发布要可控,私有材料不能因一次复制粘贴泄露到公开站点,公开文章要能对应回已审阅的原稿;手机端要回答两类问题,进度类需要实时状态,知识类需要检索。没有实际做过的部署、实验和性能数字,都会标成未验证或建议。
一、现有系统里已经有什么
这套链路建立在三块已有基础设施上。它们各自解决局部问题,但之间还没有完全接上。
第一块是学习侧的 tracker learn 命令行,它把上下文、固定源码、报告与证据、Project 更新、送审和完成串成确定性 CLI。CLI 不调用模型;理解与写作由 Agent 负责,CLI 只固定事实。学习状态以 GitHub Project 为准,报告与证据放在独立私有仓库。list 可按状态筛选,operation <request-id> --resume 可在中断后回读现场。
对发布重要的是:报告有 SHA-256,送审产生 review_id,并与那一版报告的哈希绑定;只有用户明确确认某一版,才允许执行 finish;finish 先写批准记录,再写 Project 字段,最后回读状态为 Distilled 之后才追加完成事件。批准与完成是两个事实,不能把批准时间当成完成时间。报告默认保存在 <hub>/knowledge/studies/<issue>/report.md,publication 是 local_only,不会自动 push。
证据模型也值得说明。结论分为 verified、inference、unresolved 三类;标成 verified 的结论必须引用固定 SHA 下的源码文件和行号,或者引用一次带命令、退出码、结果哈希的实验。只引用文档自述会被拒绝。这条规则约束的是证据位置和实验结果,不证明结论的语义一定正确,所以「已验证」仍需人工审阅,只是审阅时有一份可复核的记录。
第二块是博客侧。站点使用 Hexo 8.1.2 和 Node 24,源码在私有仓库的 main 分支。流程是 npm run verify:public 先做 AI 检查、私有内容检查和压缩,然后 npm run deploy 再重复一次校验,最后通过 hexo-deployer-git 推到公开的 GitHub Pages 仓库,对外提供 blog.fulequn.online。调研时本地 verify:public 基线能通过,AI 检查覆盖三篇已授权文章;远端一次失败的 CI 来自无关的依赖升级 PR,main 是通过的。当前 CI 只做验证,不负责部署;「CI 通过」不能推导出「线上已经更新」,本文自身的发布结果也不在断言范围内。
第三块是 AI 导出插件。它在构建时生成 ai/content/<ai_id>.md、带 SHA-256 的 ai/index.json 和 llms.txt。文章要在 front matter 显式写 ai_export: true、ai_id 和 ai_summary 才会导出;草稿和 published: false 不导出。ai_export 只决定是否进入 AI 索引,不决定 HTML 是否公开,两个开关不能互相替代。
调研时还做了一次只读观察:线上首页返回 200,两个 AI 入口返回 404。核对公开分支,根目录没有 ai/ 或 llms.txt,可以定位为当前部署产物缺少 AI 出口;何时、为何没有部署,仍不清楚。
三块放在一起,缺口很清楚:学习侧已经有「哪一版报告被确认」的事实,博客侧已经有公开与索引的开关,但两者之间缺一个确定性导出步骤,把已批准报告变成源稿,并把版本关系写成机器可读的记录。没有这一步,发布仍靠手工复制,文章与原稿之间也没有可靠对应。
二、候选方案与取舍
评估候选看五项:许可证与运行条件、中文检索质量、私有内容处理、部署与鉴权边界、整合成本。下面版本信息是调研时核对到的状态,不代表读者本机版本;手机端的云端版本和硬件尚未检查,不能照搬文档配置。
| 方案 | 许可与运行条件 | 中文与检索特点 | 私有内容 | 本轮结论 |
|---|---|---|---|---|
| OpenClaw 内置 memory | 需核对实际云端版本 | v2026.10.6 文档称 QMD backend 已移除,使用 memory.search.extraPaths,内置 CJK trigram 与 hybrid,无 learned reranker |
读取本地文件,适合私有目录 | 阶段 2 接入 |
| QMD v2.8.3 | MIT,Node >= 22 | CLI 提供 search、vsearch、query,支持 JSON 与 MCP stdio/http,可挂多个目录 | 本地索引,HTTP 需自行守边界 | 阶段 3 按评测选用 |
| Basic Memory v0.24.1 | AGPL-3.0 | 以笔记和关系为核心,适合人机共写 | 本地优先 | 观察,不接管审阅稿 |
| WeKnora v0.8.3 | MIT,附第三方声明 | 内置 HTTP MCP,支持 token、知识库范围和工具选择,默认只读 | 支持私有部署 | 复杂资料增多后评估 |
| Khoj | AGPL-3.0 | 聊天与检索一体 | 可私有部署 | 与 OpenClaw 聊天能力重叠 |
| GitMCP | Apache-2.0;托管服务面向公开仓库,自托管私有场景的鉴权未验证 | 面向公开仓库 | 托管不覆盖本需求,自托管待验证 | 不用于首期私有源 |
| Docling | MIT,模型另有条款 | 文档解析,保留版面与定位 | 本地运行 | 作为解析层候选 |
OpenClaw 是手机端最自然的第一站,因为它已经是实际使用的入口。v2026.10.6 文档说 QMD backend 已移除,改用 memory.search.extraPaths;内置检索对中文用 trigram 与 hybrid,没有 learned reranker。实际云端版本和硬件没有检查过,不能把文档当成现网配置说明。
QMD 是阶段 3 优先评估的独立检索层。v2.8.3 采用 MIT 许可,要求 Node 22 以上,CLI 有 search、vsearch、query,支持 JSON 与 MCP stdio/http,可挂多个目录,适合多 Agent 共用索引。中文问题仍在:issue 976 记录多词 CJK 查询中某个片段不存在时返回零结果,issue 454 记录中文查询扩展产生英文词后召回下降;调研时两者仍开放。用自己的样本复现之前,既不能推断它普遍不可用,也不能假设它够用。HTTP 模式还要核对鉴权,不能裸露到公网。
WeKnora 留到更后面。v0.8.3 采用 MIT 许可并附第三方声明,内置 HTTP MCP,支持 token、知识库范围和工具选择,默认只读;旧的 Python MCP 已经弃用。标准 Docker 部署建议 4C8G,不含本地模型;Lite 版本使用 SQLite,但没有明确的最低内存说明。它适合多源、复杂文档和团队级知识库,不适合只有几十篇笔记的阶段。Khoj 的聊天能力与 OpenClaw 重叠,GitMCP 的托管服务主要面向公开仓库,自托管私有鉴权尚未验证,因此不作为本方案私有知识入口。Docling 适合作为未来的解析层:保留原件、解析版本和页码定位,比「解析得多漂亮」更重要。
本轮没有找到能同时覆盖学习审阅、公开博客、AI 索引和手机检索的一体化方案。这个结论有边界:只说明在当前条件下没有值得替换现有链路的选项,不宣称全网不存在。与其等全能系统,不如先接好已有系统,把单篇发布闭环做扎实。
三、目标结构与三个边界
目标结构可以分成三个平面。学习面是私有的,包含 GitHub Project 看板、私有 hub 仓库、实验仓库和 tracker learn。发布面包含导出器、博客源码仓库、verify:public 校验和公开的 GitHub Pages。检索面有两类数据源:一类是公开快照,来自已部署的博客与 AI 索引;另一类是授权的私有快照,直接来自 hub 里已经完成的报告。三层分别产出报告与完成事实、文章与发布清单、可检索内容。
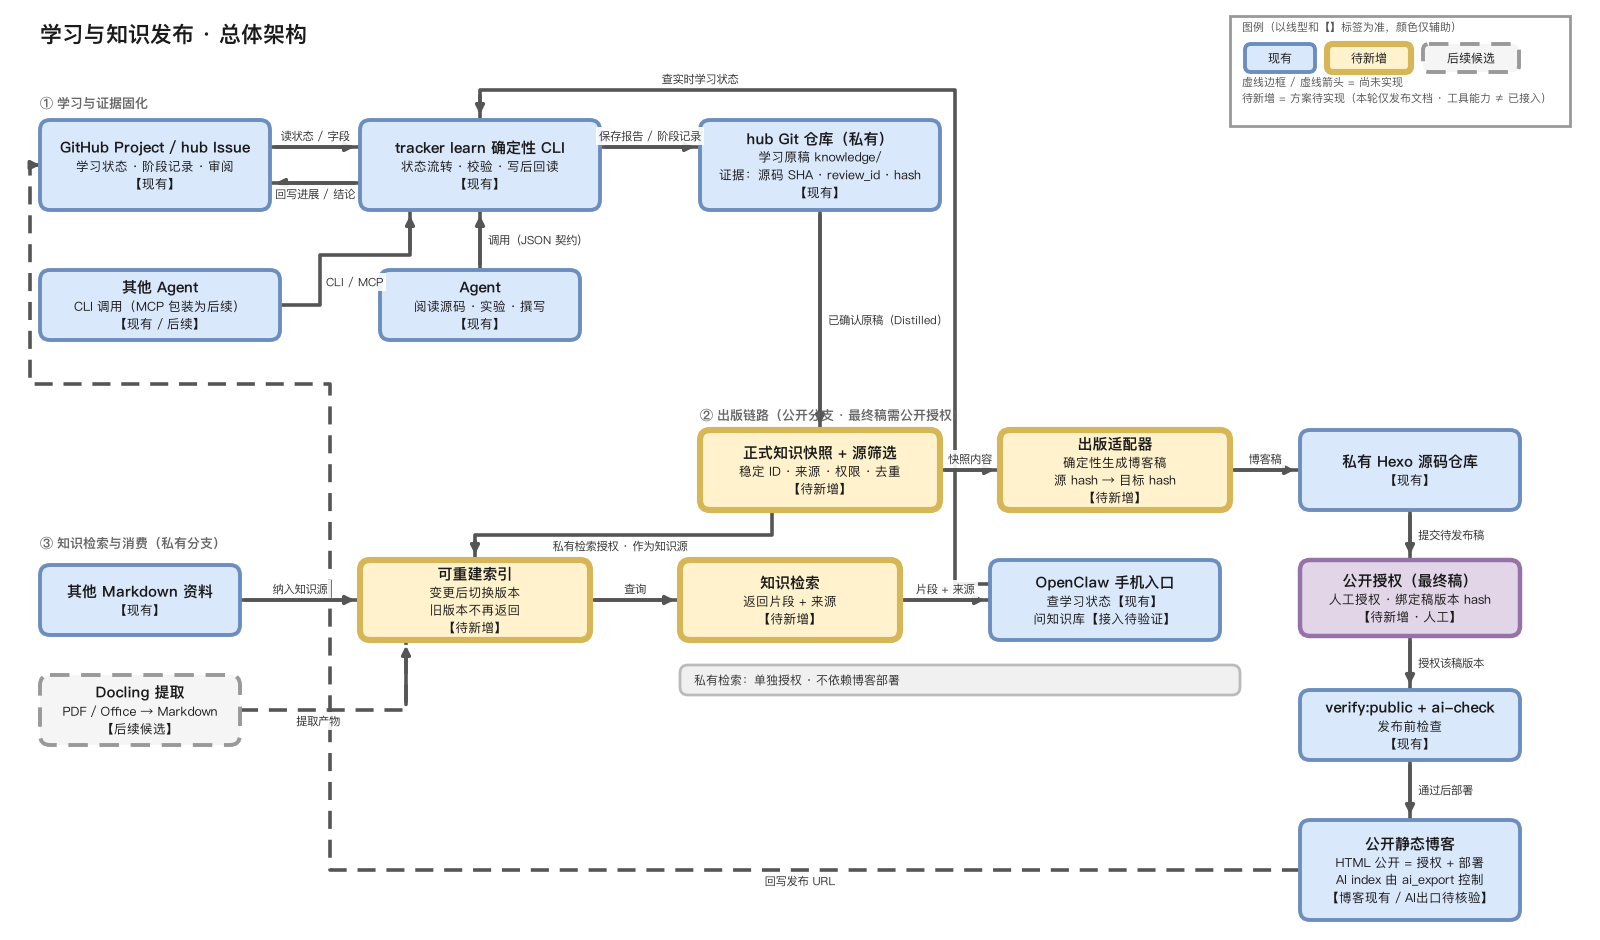
不看图也能理解这三层的关系。学习面只写私有仓库,不触碰公开站点;发布面只从学习面读取已批准的版本,生成派生稿,再经过校验后部署;检索面有两条独立路径,公开路径只读发布面正式产出的快照,私有路径读的是已授权的 hub 快照。两条路径的内容不同、授权不同,不能互相串。私有路径不依赖博客是否部署成功:报告一完成,它就可以进入授权的私有知识库。
第一个边界是内容边界。hub 里的报告是正本,博客文章是派生副本。派生意味着它可以删减、改写标题、补充公开来源,但不能反过来成为学习结论的依据。公开文章里的每个事实,要么来自已批准报告的结论,要么来自公开可核对的来源;私有仓库里的截图、内网链接、绝对路径、未公开的实验数据,一律不进入派生稿。文章可以比报告短,但不能比报告更「确定」。私有知识库可以包含 hub 快照,前提是访问者本身已获授权;被禁止的是让这些内容越过权限边界,出现在公开索引或无关用户可读的地方。
第二个边界是事实边界。学习完成、公开授权、线上部署是三件事,分别有各自的证据。学习完成由 CLI 的 completion 事件证明,公开授权由用户对某一版文章的明确同意证明,线上部署由部署记录和地址回读证明。审阅通过只说明「这一版报告可以完成」,不自动等于「这一版可以公开」;公开授权也不等于「已经部署成功」。
第三个边界是权限边界。读取私有 hub、写入博客源码、触发公开部署,是三种不同的权限。手机端不应该持有写仓库或部署的令牌;它通过认证访问一个云端 Agent,由 Agent 侧按授权读取内容,手机本地不保存 Git 令牌。云端 Agent 可以读私有快照,但只能读取当前用户被授权的那部分;公开索引是另一条授权,只收已公开的内容。CI 如果只做验证,就不需要私有 hub 的读权限;自动化导出如果存在,才需要跨仓库的读权限。
四、把「哪一版」写死
发布链路里最容易含糊的一件事,是「线上这篇文章对应哪一版报告」。文件名会重复,日期会改,标题会润色,靠这些信息追不回来。可行的办法是给每次派生一个稳定标识,并把源版本、审阅版本和公开版本写成一份清单。
下面是一份建议的清单结构。字段名和层级都是设计建议,当前 CLI 没有输出这个 schema,导出命令也尚未实现。写出来是为了让后续实现有明确的验收对象。
{
  "schema_version": 1,
  "id": "study-github-learning-pipeline",
  "source_repo": "owner/repo",
  "source_commit": "<40-hex>",
  "source_sha256": "<snapshot-manifest-sha256>",
  "study_issue": 42,
  "review_id": "rvw-42-<hash>",
  "report_sha256": "<approved-report-sha256>",
  "report_path": "<hub-relative-path>",
  "article_id": "github-learning-knowledge-pipeline",
  "article_hash": "<normalized-public-article-sha256>",
  "canonical_url": "https://blog.fulequn.online/learning/github-learning-to-blog-knowledge-base/",
  "visibility": "public",
  "ai_export": true,
  "learning_completed_at": "<ISO-8601>",
  "public_authorized_at": "<ISO-8601>",
  "deployed_at": "<ISO-8601>",
  "deploy_revision": "<pages-build-or-commit>"
}几个字段的含义需要说清楚。id 是这项研究的稳定身份,不随标题变化;source_repo 和 source_commit 固定上游版本;source_sha256 是固定源码快照的清单哈希,可以对文件路径和 blob 哈希排序后取摘要,算法要在实现时写死并版本化;review_id 与 report_sha256 一起构成「这一版报告被确认过」的随稿凭据,用于自洽校验,不是独立认证;report_path 记录报告在 hub 中的相对路径,方便回查;article_id 对应博客的 ai_id,用于索引去重;article_hash 是规范化内容哈希;canonical_url 是公开地址;deploy_revision 记录实际部署对应的 commit 或构建号。
article_hash 要区分规范化和字节两种口径。规范化哈希用于判断「内容有没有变」,它排除部署时间、构建时间、访问计数等易变字段,把正文、影响内容的 front matter 字段和图片引用按固定顺序序列化后再取 SHA-256。远端文件字节哈希用于判断「推送是否落地」,直接对仓库文件内容计算,包含换行和编码差异。两者用途不同,不能互相替代:规范化哈希一致而字节哈希不同,通常只是格式差异;在规范化算法和配置相同的前提下,字节哈希一致就应得到相同的规范化哈希;如果不一致,应检查算法版本、外部输入或实现错误,不能判定文章内容变化。幂等判断用前者,推送核实用后者。
这些字段放在哪里,也需要选择。front matter 只保留博客构建真正需要的部分,例如标题、日期、permalink、标签、分类和 ai_* 字段;审计字段放在博客仓库之外的私有控制目录里,例如 <control>/publication/studies/<issue>.json。博客源码仓库本身是私有的,但这不意味着 source/_data 里的任何字段都适合作为清单的安全默认位置:它随源码维护,也容易在构建或模板改动时被无意带进产物。私有控制目录的好处是页面元数据干净、清单可追溯。关键是已批准报告的哈希不被修改:导出器复制报告,但不在原报告上补字段,也不重算哈希。
五、端到端流程
整条链路可以拆成八步。前四步已实现,第五步起是本文建议的发布扩展。
- 接续上下文。运行
tracker learn context <issue> --json,拿到研究目录、Issue、固定源码 SHA、WIP 状态和下一步。 - 固定源码版本。Queued 第一次开始必须给出
--ref,已有 SHA 的续做不再指定新分支,保证证据回到同一个 commit。 - 保存报告与证据。
checkpoint写入报告、证据、结论和进展;ready_for_review=true时生成review_id。源码行号必须真实存在,路径必须在固定 SHA 的研究目录内。 - 用户确认某一版。只有用户明确确认
review_id对应的那一版,才执行finish。「先保存」「不错」不算批准。Project 状态回读为 Distilled 后,才追加 completion 事件。 - 导出公开稿。从已批准版本生成博客源稿和发布清单。这一步目前尚未实现,下面的命令只是接口示意。
- 确认公开稿、校验并提交。将公开授权绑定到最终文章版本,运行
npm run verify:public,通过后按仓库约定提交并推送源码,等待对应提交的 CI 成功。 - 部署并回读。按现有流程执行
npm run deploy,回读首页、文章页和 AI 入口。 - 更新检索快照。公开侧随部署更新
ai/content/<ai_id>.md、ai/index.json和llms.txt;私有侧由另一条路径从 hub 同步已授权快照,不经过博客部署。手机端通过认证访问 Agent,由 Agent 决定读哪一条。
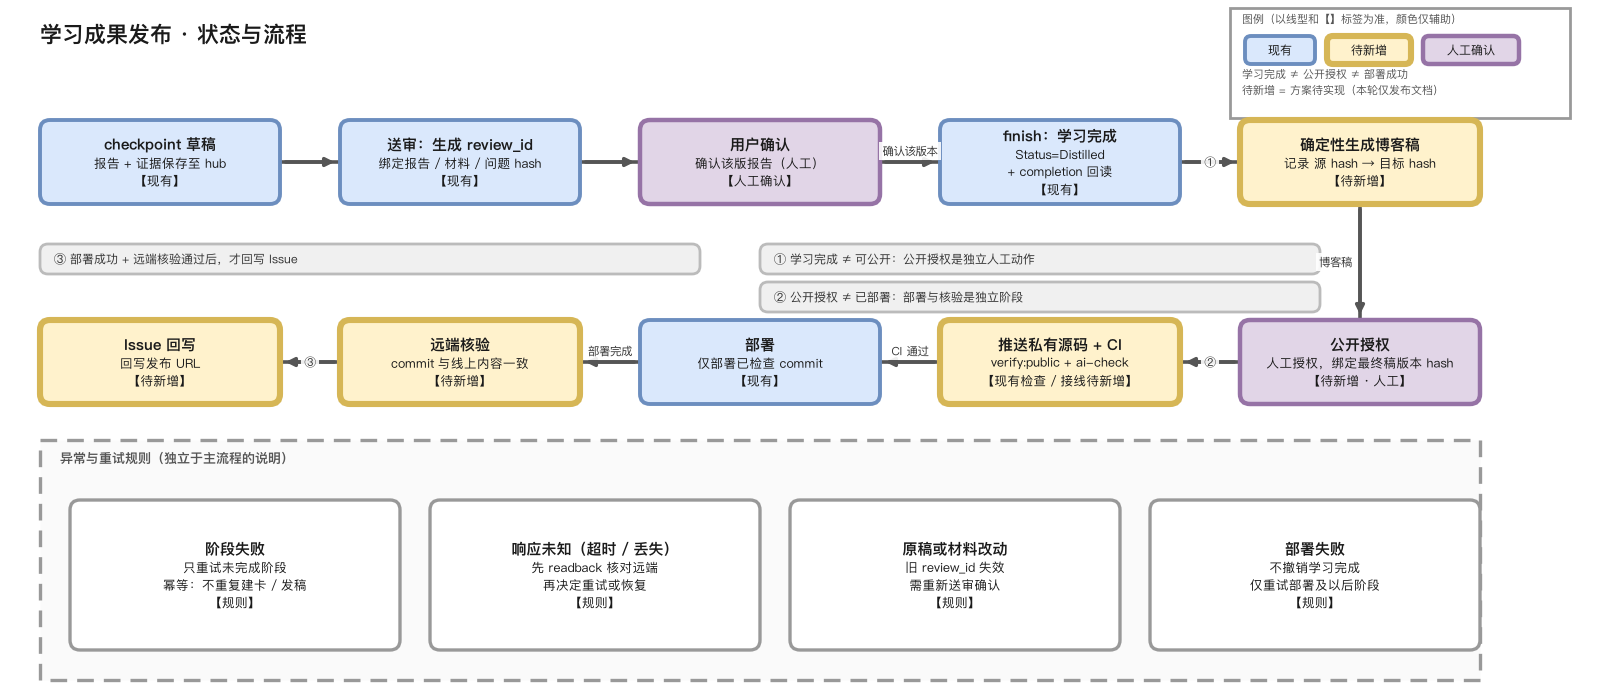
图中的关键分支在第五步和第六步之间。本地导出读取已审阅报告,可以先生成供审阅的候选稿;真正推送公开产物前必须取得覆盖最终文章版本的公开授权;校验失败时停在第六步,不进入部署;部署响应未知时停在第七步,先核实再决定是否重试。这三道闸门分别对应内容、事实和权限三个边界。
重要:
tracker learn export尚未实现。下面这条命令以及它的参数、输出和清单字段都是接口设计,不是当前可执行能力。已经实现的是context、start、checkpoint、finish及其恢复机制。
tracker learn export <issue> \
  --review-id <review-id> \
  --format hexo \
  --out <blog-repo>/source/_posts/learning/github-learning-to-blog-knowledge-base.md \
  --manifest <control>/publication/studies/<issue>.json \
  --json
导出器必须确定性,不能调用模型;相同的报告、模板和公开白名单应得到相同的 article_hash。规则包括:只复制正文和白名单元数据;私有链接替换成公开来源或删除;拒绝绝对路径、内部域名和凭据样式字符串;图片只复制明确标记为公开的素材,并要求 alt 文本;ai_export、ai_id、ai_summary 缺一即失败。遇到无法判断的内容,导出器应该失败并列出位置,而不是猜一个「大概安全」的版本。
公开授权是独立的一步。用户批准报告,不等于同意公开;用户说「可以发」,也要对应到具体版本。建议在清单里记录 public_authorized_at 和授权所指的 article_hash,内容再变则旧授权失效。授权针对版本,不针对文件名。公开授权只覆盖公开分支;私有知识库的访问授权是另一件事。
三个事实的记录方式也要分开。学习完成看 completion 事件;公开授权看清单里的授权字段和对话记录;线上部署看部署记录与地址回读。任何一项缺失,都不能用另外两项补齐。「Project 状态是 Distilled」不能证明「文章已经公开」,「线上能打开」也不能证明「用户授权过这一版」。
六、幂等、并发与响应未知
这条链路跨本机、GitHub 和公开站点,失败是常态。设计时不能假设每步都能立刻得到确定响应,要让重复执行安全、未知状态可核实。
学习侧已经有一套可复用的做法。每个业务操作带一个 request-id,同一作用域的输入变化会返回冲突;中断或远端响应丢失时,用 tracker learn operation <request-id> --resume 回读现场,只补未完成步骤,不换新 ID 重做。退出码区分成功、版本冲突、鉴权或 schema 故障、以及结果未知。发布侧应该沿用同样的思路。
导出的幂等键用规范化 article_hash。再次导出时一致则「无需变更」,不一致说明源报告或模板变了,必须重新审阅或授权,不能覆盖旧文章。写博客仓库时用写前校验:目标文件字节哈希与清单一致才写;不一致就停下来,判断是本地改动还是并发写入。
推送响应未知时应该回读远端,而不是立刻重试。看远端最新 commit、目标文件是否存在、字节哈希是否与本地一致;一致说明推送成功,补记录即可;不一致说明没落地或落了另一版,回到导出或人工判断。部署同理,先看 Pages 构建记录和线上页面,再决定是否重部署。
并发方面,首阶段只允许一个写入者。学习侧同一任务同一时刻约定只有一个写入 Agent;发布侧同一篇文章同一时刻只允许一个导出或部署流程。可以用文件锁、CI 的 concurrency group 或环境级互斥,但不能假设 GitHub 提供跨机器事务。
| 状态 | 现象 | 处理 | 禁止 |
|---|---|---|---|
| 导出中断 | 清单未写完,目标文件可能已存在 | 用同一幂等键重跑,先核对目标哈希 | 换一个新文章 ID 重做 |
| 报告已变 | 新哈希与 review_id 绑定的哈希不一致 |
停止导出,重新送审 | 覆盖已批准版本 |
| 推送未知 | 命令超时或连接中断 | 回读远端 commit 与文件哈希 | 直接 force push |
| 部署未知 | CI 或部署命令没有返回 | 查 Pages 构建记录与线上 URL | 连续重复部署 |
| 授权过期 | 文章哈希变了但授权未更新 | 重新请求公开授权 | 沿用旧授权发布 |
七、发布链路与 CI 复用
现有博客流程有两道校验:verify:public 和 deploy 内部的重复校验,前者含 AI 检查、私有内容检查和压缩。这个设计偏保守,但对公开站点合适。真正要补的是校验与版本的对应关系:让校验知道这一版对应哪份报告。
可以在 verify:public 里增加几项低成本检查:发布清单 schema 是否合法;report_sha256 是否与清单里的 review_id 记录一致;规范化 article_hash 是否与文章一致;front matter 是否包含必需的 ai_* 字段;ai_id 是否重复;文章里是否出现私有域名、绝对路径或凭据样式字符串;草稿和 published: false 是否被排除。完整审计清单保留在私有控制目录;CI 只读取随博客稿提交的最小证明副本,复用已有 ai_id 唯一性和草稿隔离检查,不访问私有 hub,不会把跨仓库权限带进 CI。代价是 CI 无法独立认证「这份报告确实被审阅过」,它只能校验随稿携带的审阅凭据是否自洽。要独立认证源报告,必须读 hub,那需要另一套权限,不适合放在公开站点的常规 CI 里。
部署任务应该和验证任务分开。验证可以在每个 PR 上跑,部署只在 main 合并后跑,并且使用受保护的环境和人工批准。部署前复用同一份构建产物,避免「验证的是 A、部署的是 B」。部署后回读:首页 200,文章页 200 且包含预期标题,canonical_url 正确,AI 入口返回预期内容。回读失败时停在部署步骤,不自动回滚;回滚应显式指向已知的上一版构建。
当前 CI 只验证不部署。合并 PR 不会自动改变线上站点,部署仍是本地或人工触发。未来交给 CI 时,需要补上环境批准、并发控制和回读。
跨仓库令牌的必要性,取决于导出发生在哪里。本地导出时,导出器在本机读私有 hub,提交文章到博客仓库,当前 CI 只做验证,部署由人工触发,不需要 hub 读权限,权限最小,首阶段应该选它。CI 自动导出才需要读 hub、写博客仓库和触发部署,这时用 GitHub App 安装令牌或细粒度 PAT,只授予目标仓库的 contents: read 或 contents: write,设置短有效期,放在受保护的环境 secret 里,并确保日志脱敏。第三条路径是 PR 模式:自动化读取 hub 后创建分支或 PR,仍需博客仓库的相应写入权限;合并与部署由人控制,不能把 PR 模式描述成完全只读。
手机端不应该持有写权限或部署令牌,也不需要持有 Git 读令牌。它通过认证访问云端 Agent,由 Agent 侧按用户身份读取公开或私有快照。把 hub 的读令牌放进手机,等于把私有知识库的边界交给一台可能丢失的设备;正确做法是把鉴权留在服务端,手机只保存会话凭据。
八、公开博客与 AI 索引
公开范围的规则不复杂,但容易被误解。source/_posts 是公开的,private/ 不公开;ai_export: true 决定是否进入 AI 索引,不决定 HTML 是否公开;草稿和 published: false 不导出。一个常见错误是以为「没写 ai_export 就不会公开」,实际上它仍可能作为普通文章发布;另一个错误是以为「写了 ai_export: true 就自动公开」,实际上它只是索引开关。发布前应该同时检查 HTML 可见性和索引可见性。
公开 AI 索引只收正式确认过的快照。所谓正式确认,至少包括公开授权和部署成功两个条件;只有 PR 里的草稿、只有本地构建的产物、只有 ai_export: true 但还没上线的文章,都不应该进入手机端可读的公开索引。索引按 ai_id 去重,同一篇文章的多个副本只保留规范地址对应的那一份;ai/index.json 记录内容文件的 SHA-256,读取方可以用它判断快照是否过期。llms.txt 提供一个入口,但它不替代索引,也不应该列出未公开内容。私有快照不经过这套索引,它有自己的授权和更新路径。
不建议索引所有 Markdown。博客仓库里还有页面、草稿、私有目录、构建产物和临时文件,全量索引会把不该出现的内容带进检索,也会让体积和更新成本失控。更稳妥的做法是维护白名单:只有 source/_posts 下、ai_export: true、已发布、且通过私有内容检查的文章才进入公开索引,而且必须能被 CI 检查。
两个 AI 入口 404 的直接原因已经定位:公开分支根目录没有 ai/ 和 llms.txt,部署产物缺了 AI 出口。但「构建成功」和「入口可用」仍是两回事。下次发布后要按顺序回读:构建产物里是否有 ai/index.json、llms.txt 和 ai/content/*.md;路由是否映射到预期路径;插件版本是否匹配;CDN 或缓存是否还在提供旧版本。
九、手机端:两类问题,两条路径
手机端的目标是「问对地方」,让两类问题各自走到合适的后端。
第一类是进度问题,例如「我这周学了什么」「五号任务卡在哪」「有哪些在学的」。这类问题需要实时状态,应该直接走 tracker learn list、context 或 report 这类 CLI,而不是查索引。索引是快照,可能滞后;进度是状态,滞后就会误导。OpenClaw 的 Skill 封装这些命令,底层仍是 CLI。
第二类是知识问题,例如「之前研究的会话恢复机制是怎么做的」「那个项目为什么不用轮询」。这类问题适合检索:公开内容走公开索引,已授权的私有研究走私有快照,路由层按用户权限决定能查哪一边。两条路径都要返回带引用的段落,并说明内容来自哪篇文章、哪一版。私有快照让检索不依赖博客是否部署;公开索引只覆盖已发布内容。检索结果不足时,助手应该说「现有笔记没有覆盖」,而不是用模型常识补一个看起来合理的答案。两类问题的分界要在 Skill 的路由层写清楚。
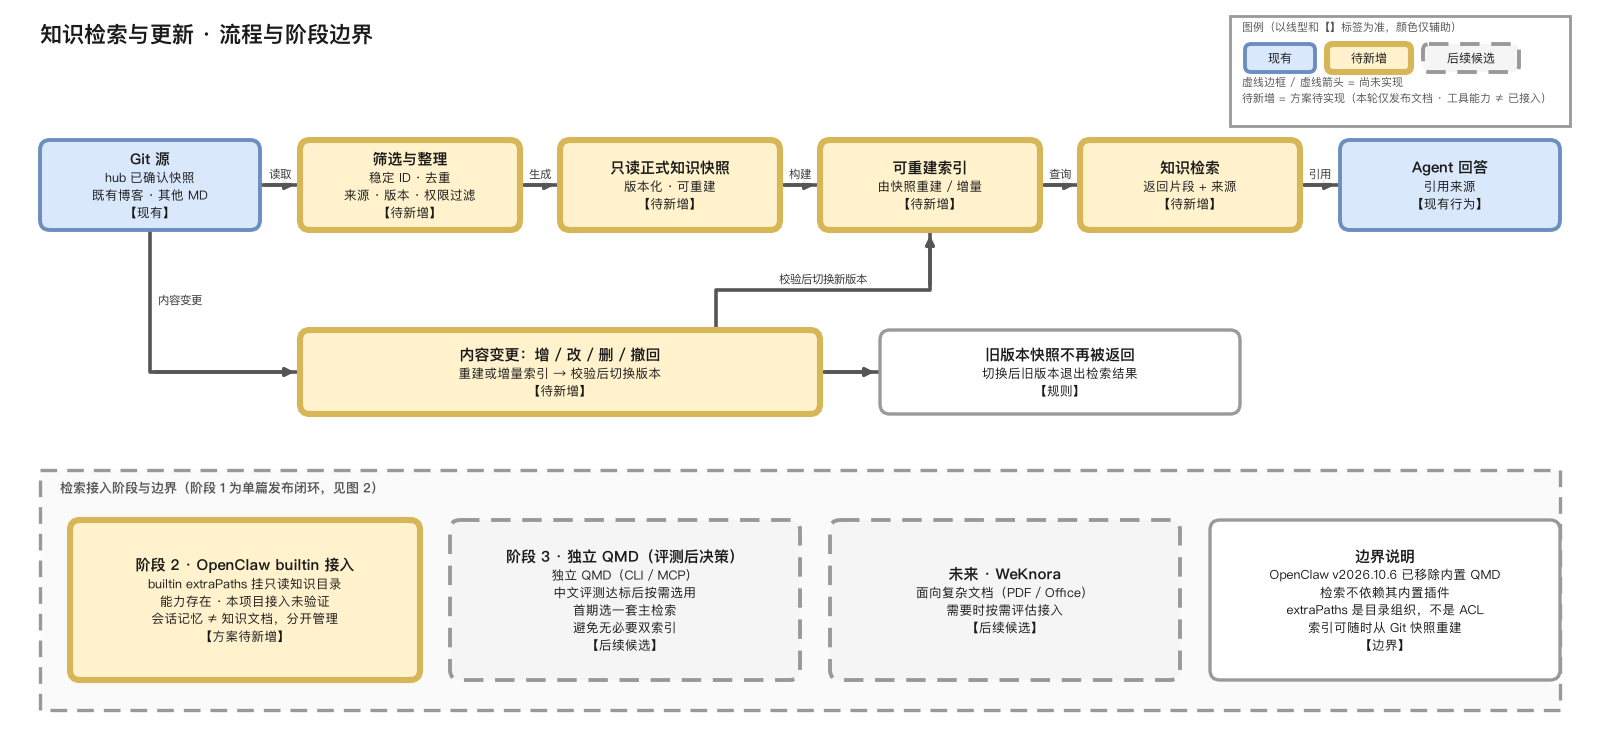
阶段 2 的手机端方案,建议直接用 OpenClaw 内置 memory 的 memory.search.extraPaths,按授权挂两个目录:一个只放已公开、已确认的笔记,另一个放当前用户可见的私有快照。目录划分只用于组织语料,extraPaths 本身不是逐用户访问控制。首期仅让本人通过认证的私聊入口使用私有索引;如果还服务群聊或其他用户,应隔离 Agent、索引与工具权限,并验证跨会话不泄漏,不能只依靠提示词过滤。私有快照可以直接从 hub 同步,不要求博客已经部署。OpenClaw v2026.10.6 文档说内置检索对中文使用 trigram 并支持 hybrid,没有 learned reranker;它对短语和标识符可能不错,对语义改写和长问题不一定强。先建立 builtin 基线,再用阶段 3 的评测数据决定是否需要独立检索。
阶段 3 再评估 QMD 作为独立检索层。v2.8.3 的 CLI 和 MCP 接口更适合多 Agent 共用:一个 Agent 建索引,另一个查询,手机端只读。它可以挂多个目录,也可以用 JSON 输出接入自定义 Skill。但中文 issue 976 和 454 仍然开放,必须先用自己的样本集验证,不能因为英文效果好就默认中文也好。QMD 只是候选,是否替换内置检索由评测决定,不是既定目标。HTTP 模式如果要用,必须加独立鉴权和访问控制;stdio 模式更适合本机或受控环境。
十、中文检索怎么评测
候选方案的中文能力不能靠感觉判断,需要固定语料、问题集和判定规则,每次换模型、换分块、换 top-k 都记录同一套可比较配置。将首批问题分成开发集与冻结保留集,例如 20 题用于定位问题、10 题留待方案确定后验收;不要在保留集上反复调参。
样本类别至少覆盖以下几类。首阶段用 20 到 30 条真实中文问题建立基线,覆盖主要类别;链路稳定后再扩到 60 到 100 条,补上多跳、权限边界这类需要构造的样本。问题应当来自真实使用,不要为了凑数编造。
| 类别 | 查询意图 | 判定要点 |
|---|---|---|
| 中文技术叙述 | 用中文问一个机制或设计取舍 | 能否召回对应段落,而不是只匹配标题 |
| 中英混排 | 中文问题里夹函数名、类名或配置项 | 标识符必须精确命中 |
| 代码标识符 | 直接搜 review_id、extraPaths 这类词 |
不应被分词拆碎 |
| 版本与路径 | 问某个版本、文件或配置项 | 版本号和路径不能被模糊匹配吃掉 |
| 同义术语 | 「会话」与 session、「索引」与 index | 语义检索应覆盖,关键词检索可兜底 |
| 多跳问题 | 需要两篇文章或两段内容才能回答 | 能否返回两个来源并正确合并 |
| 无答案 | 语料里没有的问题 | 应明确说不知道,不能编 |
| 权限边界 | 以无权限身份查询私有材料,或查询已撤回内容 | 不得返回受限片段;授权用户仍可检索其私有快照 |
指标不用太多。Recall@5 看前五条是否含正确段落;MRR 看第一个正确结果多靠前;引用正确率看引用是否支持结论;无答案准确率看该拒答时是否拒答;越权泄露率看未获授权的内容是否出现,目标为 0;延迟看 p95,门槛在基线测出后再定。中文标识符精确匹配可以单独设门槛。
建议的验收门槛是条件性的:在固定语料和问题集上,可回答类别的 Recall@5 不低于 0.8,MRR 不低于 0.6,引用正确率不低于 0.9,无答案准确率不低于 0.9,越权泄露为 0;任何类别相对基线的下降不超过 0.05。这些数字是建议,不是实测结果。实施时先跑基线,再按语料难度调整;基线很低时,先修语料和分块。
评测工具也应该版本化。每次运行记录语料快照、问题集版本、模型、分块参数、top-k 和原始输出;判定可以由人做,也可以机器初判再人工复核。有争议的问题保留判定理由,不要只留一个分数。这样换方案时,才知道变好是因为检索,还是因为问题变简单了。
本文写作时这套评测还没有完成。没有实测数据,就不能说 QMD 的中文效果如何,也不能说 OpenClaw 内置检索够不够用。评测是阶段 3 的决策依据,不是既成事实。
十一、分阶段实施
先建立单篇发布闭环,再接手机端 builtin,随后比较独立检索候选。自动化和多来源在链路稳定后逐步增加;WeKnora 与 Docling 只在资料类型和运维条件需要时评估,不是自动化的前置条件。
| 阶段 | 交付 | 退出条件 | 依赖 |
|---|---|---|---|
| 0. 边界与样本 | 公开白名单、清单 schema、20–30 条真实中文问题、权限清单 | 白名单和字段评审通过;问题集有人工标注 | 现有报告与博客样本 |
| 1. 单篇闭环 | 导出器 MVP、发布清单、verify:public 新检查 |
一篇文章从批准到上线全程可回读;三个事实各有记录;无私有内容泄露;索引只有一条 | 阶段 0 |
| 2. 手机接入 | OpenClaw 只读目录、问题路由、引用格式 | 公开与授权私有两类问题都能回答;越权为 0;无答案能拒答 | 已确认快照与服务器版本;私有检索不以博客部署成功为前提 |
| 3. 检索评测 | builtin 与 QMD 的中文对比;按结果选择 CLI/MCP 接入 | 冻结保留集达到约定门槛;鉴权确认;多 Agent 不互相覆盖 | 阶段 2 基线和已标注问题集 |
| 4. 自动化与多来源 | 按需增加导出自动化、同步和更多 Markdown 来源 | 可恢复、可审计;版本与权限检查持续通过 | 已验证的发布及检索链路 |
| 后续按需评估 | WeKnora 试点、Docling 解析、PDF/Office 等资料 | 现有方案无法满足需求;解析与引用可回溯;运维成本可接受 | 实际资料构成和资源评估,不强制依赖 QMD |
阶段 1 的核心是「跑完之后能证明它是哪一版」;导出命令能跑只是前提。清单、哈希、授权记录、部署回读,这四样缺一不可。可以先只支持一种模板、一种 front matter、一个公开目录,把确定性做出来,再扩模板。导出器宁可拒绝,也不要猜。阶段 2 把手机端接上:先接公开目录,再按授权接私有快照;两类问题分别路由,不要用一个索引硬扛。
阶段 3 的核心是用评测决定选型。QMD 能跑起来不代表中文检索达标;MCP 能连上不代表权限边界正确。先把阶段 0 的问题集跑一遍,再决定是否把手机端从内置 memory 切到 QMD。如果内置 memory 已经够用,可以继续沿用 builtin;确有跨 Agent 需求时再考虑独立只读索引,不强制替换手机端方案。
后续复杂文档平台的决策依据是实际需求。WeKnora 解决的是多源、复杂文档和团队级知识库的问题;资料仍以 Markdown 为主时,单机索引足够。Docling 也只在 PDF、Office 比例高到影响使用时才值得引入。
工期需在单篇试点后估算,本文没有实施工时证据。阶段 1 可以在本机完成;阶段 2 先核对已有腾讯云服务器的版本与余量;阶段 3 记录不同检索配置的资源消耗。只有考虑 WeKnora 标准部署时,才进一步评估文档建议的 4C8G 级容器及模型额外开销。
十二、运维与恢复
运维目标是「失败后知道停在哪、从哪里恢复」,不追求「永不失败」。下面按症状组织检查表。
| 症状 | 先查什么 | 处理 | 停止条件 |
|---|---|---|---|
| 导出后文章内容不对 | 报告哈希、模板版本、清单 | 用同一幂等键重新导出 | 源报告已变,回到审阅 |
verify:public 报私有内容 |
命中的文件与行号 | 修正源稿或白名单 | 不能绕过检查发布 |
| 推送超时 | 远端 commit、目标文件哈希 | 回读确认后补记录 | 哈希不一致,人工判断 |
| 部署后页面 404 | 构建产物、路由、部署批次 | 回滚到上一版或重新部署 | 连续两次失败,停止自动重试 |
| AI 入口 404 | ai/ 产物、插件配置、缓存 |
重建并回读 | 原因未查清前不改线上配置 |
| 索引哈希不符 | 内容文件与 ai/index.json |
重新构建索引 | 手改 JSON 不可接受 |
| 手机答非所问 | 问题路由、索引快照、top-k | 调整路由或重建索引 | 未授权内容出现,立即停用相关入口 |
| 令牌过期 | CI secret、令牌范围 | 轮换令牌,重跑失败步骤 | 不扩大权限范围 |
索引是派生数据。如果检索层用 SQLite 或向量库,它应该能从快照重建,不需要跨设备同步,也不应该成为唯一副本。备份沿用现有仓库:hub 和博客源码有 Git 历史,公开站点有 Pages 的构建记录,发布清单随私有控制目录版本化;恢复时先恢复清单,再恢复文章,最后重建索引,顺序反了,索引会指向不存在的版本。
删除或撤下内容要走单独的流程,不能只删文章文件。撤回无法保证抹除公开 Git 历史、第三方副本或搜索引擎缓存;只能验证受控入口当前不再提供内容,并记录尚未传播完成的节点。先撤销公开授权,停止后续发布;再从公开站点移除 HTML、AI 内容并清理缓存;然后删除索引条目,重建并确认它不再出现;最后做负向查询验收,用标题、URL 和关键句搜索,确认都检索不到。私有分支的撤权是另一件事,公开撤稿不能顺带改变私有知识库的访问权限。撤回记录要保留,谁在什么时候撤了什么,应该能回查。
监控不需要很重。首页、文章页、AI 入口各自 200,清单哈希与文章哈希一致,索引中的 ai_id 不重复,再加最近部署和成功回读时间,就足以区分「没更新」和「更新失败」。
十三、不做清单
有些事看起来顺手,实际会把边界破坏掉。首阶段明确不做,理由如下。
- 不做新的笔记应用或 CMS。现有 hub、博客和 CLI 已覆盖写作、版本和发布,新增系统只会多一份要同步的状态。
- 不让
finish自动发布。学习完成和公开授权是两个事实,自动发布会把用户的确认变成默认同意。 - 不索引所有 Markdown。全量索引会把草稿、私有目录和构建产物带进检索,也会让权限边界失效。
- 不把 QMD 的 HTTP 服务直接暴露公网。独立鉴权边界还没核对,裸露端口等于把知识库交给扫描器。
- 不让 Basic Memory 修改已审阅报告。报告的价值在哈希稳定,另一个写入者会破坏审阅绑定。
- 不用托管 GitMCP 解决私有仓库。它面向公开仓库,私有内容本来就不该出现在第三方托管索引里。
- 不在手机保存 Git 读令牌、写权限或部署令牌。手机是消费端,鉴权应留在服务端。
- 不首期上 WeKnora 多源。资料类型和规模还没到需要它的程度,部署成本先于收益发生。
- 不做 hub 与博客的双向同步。双向同步会产生两个正本,冲突时无法判断哪边可信。
- 不自动生成未经审阅的摘要。
ai_summary可以由 Agent 起草,但必须随文章一起审阅。 - 不把
ai_export当访问控制。它只控制索引,公开范围要靠source/_posts和private/的目录边界。 - 不编造部署、实验或性能结果。没跑过的就是没跑过,未验证的就标未验证。
十四、上游共建
这条链路依赖的几个项目都在活跃演进,遇到问题应该回到上游,而不是在本地打补丁。
QMD 的中文问题最值得投入。issue 976 和 454 仍然开放,中文检索还有改进空间。与其催维护者,不如提供可复现的语料和期望结果:一组中文技术段落、一组中英混排查询、一组标识符查询,附上当前 top-k 和期望命中的段落。这样的 issue 比「中文效果不好」有用得多。
OpenClaw 的文档也值得补。v2026.10.6 明确说 QMD backend 移除、改用 memory.search.extraPaths,但不同版本的配置差异、中文边界、Skill 如何复用外部 CLI,迁移时容易踩坑。可以把「从旧版迁移到 extraPaths」写成可复现步骤,附上版本号。
WeKnora 的 MCP 文档可以补鉴权边界和 Lite 资源说明。v0.8.3 的内置 HTTP MCP 支持 token、知识库范围和工具选择,默认只读,这是好设计;但读者仍需要知道 token 的最小权限、如何限制知识库范围、Lite 在什么数据量下会吃紧。
Docling 可以补中文 PDF 的版面与表格样本。它的价值在于保留结构和定位,但中文文档的段落、表格、页眉页脚处理需要真实样本验证。贡献一组可公开的样本和期望输出,比泛泛地说「中文支持不好」更有帮助。
Hexo 的 AI 导出插件已经包含 ai_id 唯一性和草稿隔离的测试,这两项不需要再从零提。可以补的是发布清单校验:让插件读取一份外部清单,校验 ai_id、内容哈希和授权状态是否一致。V1 目前还没有正式发布到 npm,提交前要先确认维护者希望的接入方式,不要假设安装命令。提交时不要带私有文章内容,用合成样本即可。
十五、开放问题
还有一些问题,当前没有足够证据回答,留到实施时验证。
- 手机端实际使用的 OpenClaw 是哪个版本,运行在什么硬件上?这决定了
extraPaths和内置检索的真实能力,不能拿最新文档代替。 - 公开产物缺少
ai/和llms.txt已确认,但何时、为何没有部署进去仍不清楚。查清前不建议改线上配置。 - QMD 的中文问题在 v2.8.3 之后是否已有改善?需要用自己的样本集验证,不能只看 issue 状态。
- 多语 embedding 换成哪一个模型?换模型会改变索引和召回,必须重新评测,并记录模型版本。
- 索引新鲜度要求是什么?是每次部署更新,还是按天重建?这会影响成本和无答案问题的表现。
- 公开授权的粒度是整篇还是段落?如果允许段落级授权,清单和校验都要更细。
- 引用上游代码和文档的许可证边界在哪里?公开文章引用片段时,要保留来源和许可说明。
- 评测集由谁维护、多久更新一次?没有维护机制,分数很快会失真。
这些问题不影响首阶段动工,但会影响后续方案选择。
参考资料
- Hexo 文档,Front-matter:https://hexo.io/docs/front-matter
- OpenClaw v2026.10.6,内置 memory 说明:https://github.com/openclaw/openclaw/blob/v2026.10.6/docs/concepts/memory-builtin.md
- OpenClaw 文档,memory 配置参考:https://docs.openclaw.ai/reference/memory-config
- OpenClaw 文档,Skills:https://docs.openclaw.ai/tools/skills
- QMD v2.8.3:https://github.com/tobi/qmd/tree/v2.8.3
- QMD issue 976:https://github.com/tobi/qmd/issues/976
- QMD issue 454:https://github.com/tobi/qmd/issues/454
- Basic Memory:https://github.com/basicmachines-co/basic-memory
- WeKnora v0.8.3,MCP 文档:https://github.com/Tencent/WeKnora/blob/v0.8.3/website-docs/03-features/08-mcp.md
- WeKnora v0.8.3,安装说明:https://github.com/Tencent/WeKnora/blob/v0.8.3/website-docs/01-getting-started/02-installation.md
- WeKnora v0.8.3,许可证:https://github.com/Tencent/WeKnora/blob/v0.8.3/LICENSE
- Khoj:https://github.com/khoj-ai/khoj
- GitMCP:https://github.com/idosal/git-mcp
- Docling:https://github.com/docling-project/docling
- 本文公开地址:https://blog.fulequn.online/learning/github-learning-to-blog-knowledge-base/