算法训练3.1 单调栈自顶向下的动态规划(记忆化搜索)第一部分
前言
记忆化搜索其实就是在递归的基础上记录已经算过的状态,下次如果运算过相同的状态后,直接返回已经算过的状态,避免重复运算。
这种算法在笔试过程中是非常好用的一个算法,能够解决非常多的问题,特别是一些比较复杂的动态规划,用记忆化搜索可以很快且很形象的解决问题。
打家劫舍
你是一个专业的小偷,计划偷窃沿街的房屋。每间房内都藏有一定的现金,影响你偷窃的唯一制约因素就是相邻的房屋装有相互连通的防盗系统,如果两间相邻的房屋在同一晚上被小偷闯入,系统会自动报警。
给定一个代表每个房屋存放金额的非负整数数组,计算你 不触动警报装置的情况下 ,一夜之内能够偷窃到的最高金额。
示例 1:
输入:[1,2,3,1]
输出:4
解释:偷窃 1 号房屋 (金额 = 1) ,然后偷窃 3 号房屋 (金额 = 3)。
偷窃到的最高金额 = 1 + 3 = 4 。

示例 2:
输入:[2,7,9,3,1]
输出:12
解释:偷窃 1 号房屋 (金额 = 2), 偷窃 3 号房屋 (金额 = 9),接着偷窃 5 号房屋 (金额 = 1)。
偷窃到的最高金额 = 2 + 9 + 1 = 12 。

提示:
1 <= nums.length <= 100
0 <= nums[i] <= 400
题目解析
我们从头开始考虑每一家,每一家都有两种选择,要么偷,要么不偷,在两条不同的递归路径中选取最大的即可。式子如下
f(i) = max(f(i + 1), f(i + 2) + nums[i])
代码展示
class Solution {

    // rob 方法用于计算打劫一个数组中所有房屋的最大总金额
    // 问题约束是不能连续打劫相邻的房屋
    public int rob(int[] nums) {
        // 初始化动态规划数组 dp,其长度与输入数组 nums 相同
        dp = new int[nums.length];
        // 使用 Arrays.fill 方法将 dp 数组的所有元素初始化为 -1,表示未计算过
        Arrays.fill(dp, -1);
        // 调用 dfs 方法从索引 0 开始进行递归计算
        return dfs(0, nums);
    }

    // dp 数组用于存储动态规划的中间结果
    int[] dp;

    // dfs 方法是一个递归方法,用于计算从索引 index 开始打劫 nums 数组的最大总金额
    int dfs(int index, int[] nums) {
        // 如果索引 index 超出数组 nums 的长度,说明无法再打劫,返回 0
        if (index >= nums.length) {
            return 0;
        }
        // 如果 dp 数组在当前索引 index 已经有值,直接返回该值,避免重复计算
        if (dp[index] != -1) {
            return dp[index];
        }
        // 否则,计算两种选择的金额:跳过当前房屋和打劫当前房屋
        // 打劫当前房屋的金额是当前房屋金额加上跳过下一个房屋后的金额(即从 index + 2 开始的金额)
        // 比较这两种选择,取较大值作为结果,并存储在 dp 数组中
        return dp[index] = Math.max(dfs(index + 1, nums), dfs(index + 2, nums) + nums[index]);
    }
}
class Solution:
def rob(self, nums: List[int]) -> int:
@lru_cache(maxsize=None)
def dfs(i):
if i >= len(nums): return 0
return max(dfs(i+1), dfs(i+2) + nums[i])
return dfs(0)打家劫舍 II
你是一个专业的小偷,计划偷窃沿街的房屋,每间房内都藏有一定的现金。这个地方所有的房屋都 围成一圈 ,这意味着第一个房屋和最后一个房屋是紧挨着的。同时,相邻的房屋装有相互连通的防盗系统,如果两间相邻的房屋在同一晚上被小偷闯入,系统会自动报警 。
给定一个代表每个房屋存放金额的非负整数数组,计算你 在不触动警报装置的情况下 ,今晚能够偷窃到的最高金额。
示例 1:
输入:nums = [2,3,2]
输出:3
解释:你不能先偷窃 1 号房屋(金额 = 2),然后偷窃 3 号房屋(金额 = 2), 因为他们是相邻的。

示例 2:
输入:nums = [1,2,3,1]
输出:4
解释:你可以先偷窃 1 号房屋(金额 = 1),然后偷窃 3 号房屋(金额 = 3)。
偷窃到的最高金额 = 1 + 3 = 4 。

示例 3:
输入:nums = [1,2,3]
输出:3

提示:
1 <= nums.length <= 100
0 <= nums[i] <= 1000
题目解析
此题与”打家劫舍”基本一致,一个技巧就是我们应该分两段来考虑,一段是[0, nums.length - 2] 另一端是 [1, nums.length - 1]。分别对这两段进行“打家劫舍”的操作然后取最大值即可得出正确答案。
当然这里不需要重新建立数组,我们只需要在递归的时候标记起点和终点即可。值得注意的一点是mem数组在两次递归的时候需要重新 初始化。
代码展示
class Solution {
    // 动态规划解决打家劫舍问题
    public int rob(int[] nums) {
        // 如果只有一间房屋,则直接返回该房屋的金额
        if (nums.length == 1) return nums[0];
        // 初始化备忘录数组
        mem = new int[nums.length];
        // 将备忘录数组所有元素初始化为-1,表示未计算过
        Arrays.fill(mem, -1);
        // 计算从第一间房屋到倒数第二间房屋的最大金额
        int ans = dfs(0, nums.length - 1, nums);
        // 清空备忘录数组,重新初始化为-1
        Arrays.fill(mem, -1);
        // 计算从第二间房屋到最后一间房屋的最大金额
        ans = Math.max(ans, dfs(1, nums.length, nums));
        return ans;
    }

    // 备忘录数组,记录每个房屋到最后一间房屋的最大金额
    int[] mem;

    // 递归函数,计算从第idx间房屋到第end间房屋的最大金额
    private int dfs(int idx, int end, int[] nums) {
        // 如果房屋索引超过或等于end,返回0
        if (idx >= end) return 0;
        // 如果备忘录中已经计算过该索引位置的最大金额,则直接返回备忘录中的结果
        if (mem[idx] != -1) return mem[idx];

        // 计算当前房屋偷窃和不偷窃两种情况下的最大金额,并取其中较大值
        int ans = Math.max(dfs(idx + 1, end, nums), dfs(idx + 2, end, nums) + nums[idx]);
        // 将计算得到的最大金额存入备忘录数组中
        mem[idx] = ans;

        return ans;
    }
}
class Solution:
    def rob(self, nums: List[int]) -> int:
        if len(nums) == 1: return nums[0]
        def dfs(i, nums, dp):
            if i >= len(nums): return 0
            if i in dp: return dp[i]
            dp[i] = max(dfs(i+1,nums,dp), dfs(i+2,nums, dp) + nums[i])
            return dp[i]
        return max(dfs(0, nums[1:], {}), dfs(0, nums[:-1], {}))
打家劫舍 III
小偷又发现了一个新的可行窃的地区。这个地区只有一个入口,我们称之为 root 。
除了 root 之外,每栋房子有且只有一个“父“房子与之相连。一番侦察之后,聪明的小偷意识到“这个地方的所有房屋的排列类似于一棵二叉树”。 如果 两个直接相连的房子在同一天晚上被打劫 ,房屋将自动报警。
给定二叉树的 root 。返回 在不触动警报的情况下 ,小偷能够盗取的最高金额 。
示例 1:
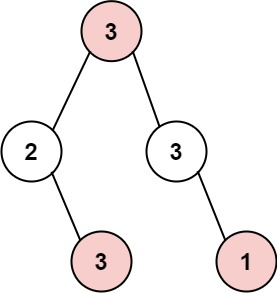
输入: root = [3,2,3,null,3,null,1]
输出: 7
解释: 小偷一晚能够盗取的最高金额 3 + 3 + 1 = 7
示例 2:
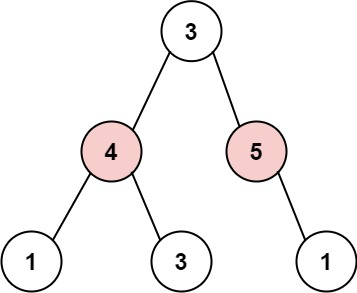
输入: root = [3,4,5,1,3,null,1]
输出: 9
解释: 小偷一晚能够盗取的最高金额 4 + 5 = 9
提示:
树的节点数在 [1, 10^4] 范围内
0 <= Node.val <= 10^4
题目解析
对于任意一个树节点,我们都有两种选择,要么偷,要么不偷。如果选择了偷当前这个节点,那么则不能考虑当前节点的孩子节点,应该取考虑孙子节点。如果选择不偷当前这个节点,则可以考虑当前节点的孙子节点。在两种操作中选择最大的即可。
值得注意的是,这里不适合用数组进行缓存,因为状态是一个TreeNode,因此选择用哈希表来进行缓存。
代码展示
class Solution {

    public int rob(TreeNode root) {
        // 调用递归函数,返回最大金额
        return dfs(root);
    }

    // 哈希表,用于记录每个节点的最大金额
    HashMap<TreeNode, Integer> mem = new HashMap<>();

    // 递归函数,计算以当前节点为根节点的子树的最大金额
    private int dfs(TreeNode node) {
        // 如果当前节点为空,返回0
        if (node == null) return 0;
        // 如果哈希表中包含当前节点,直接返回哈希表中存储的结果
        if (mem.containsKey(node)) return mem.get(node);

        // 选当前节点
        int lf = 0, rt = 0;
        if (node.left != null) lf = dfs(node.left.left) + dfs(node.left.right);
        if (node.right != null) rt = dfs(node.right.left) + dfs(node.right.right);
        int select = node.val + lf + rt;

        // 不选当前节点
        int unselect = dfs(node.left) + dfs(node.right);

        // 取选和不选当前节点的最大值作为结果
        int ans = Math.max(select, unselect);

        // 将计算得到的结果存入哈希表中
        mem.put(node, ans);

        return ans;
    }
}
class Solution:
def rob(self, root: Optional[TreeNode]) -> int:
@cache
def dfs(node):
if not node: return 0
unsel = dfs(node.left) + dfs(node.right)
sel = node.val
if node.left:
sel += dfs(node.left.left) + dfs(node.left.right)
if node.right:
sel += dfs(node.right.left) + dfs(node.right.right)
return max(unsel, sel)
return dfs(root)目标和
给你一个整数数组 nums 和一个整数 target 。
向数组中的每个整数前添加 ‘+’ 或 ‘-’ ,然后串联起所有整数,可以构造一个 表达式 :
例如,nums = [2, 1] ,可以在 2 之前添加 ‘+’ ,在 1 之前添加 ‘-’ ,然后串联起来得到表达式 “+2-1” 。
返回可以通过上述方法构造的、运算结果等于 target 的不同 表达式 的数目。
示例 1:
输入:nums = [1,1,1,1,1], target = 3
输出:5
解释:一共有 5 种方法让最终目标和为 3 。
- 1 + 1 + 1 + 1 + 1 = 3
+1 - 1 + 1 + 1 + 1 = 3
+1 + 1 - 1 + 1 + 1 = 3
+1 + 1 + 1 - 1 + 1 = 3
+1 + 1 + 1 + 1 - 1 = 3

示例 2:
输入:nums = [1], target = 1
输出:1
提示:
1 <= nums.length <= 20
0 <= nums[i] <= 1000
0 <= sum(nums[i]) <= 1000
- 1000 <= target <= 1000
题目解析
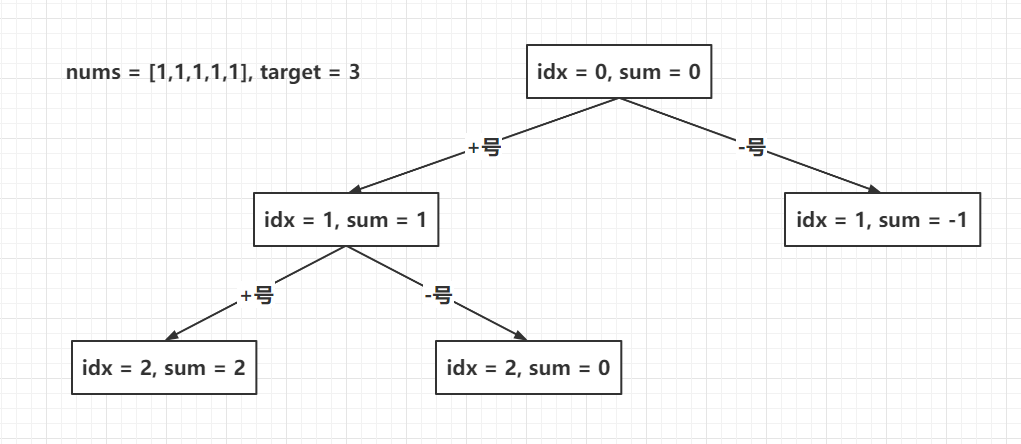
题目明显地说了每个数要么加+号,要么加-号,因此递归方向就是两个。只要最终所有元素遍历完并且和为target的时候,就有一种答案,表达式如下:
f(i, j) = f(i + 1, j + nums[i]) + f(i + 1, j - nums[i])
递归三个核心如下:
- 递归参数:
idx当前遍历元素的下标,sum当前和 - 出口:当
idx ≥ nums.length - 方向:
+号和-号
这里的记忆化数组mem需要注意的一个点:第二个维度sum是有可能存在负数的,但是数组下标不能表示负数,因此,我们需要讲sum总体加1000,避免出现负数的情况(数组总和是[0, 1000])。
代码展示
class Solution {
    // 找到目标和的方法
    public int findTargetSumWays(int[] nums, int target) {
        // 初始化备忘录数组
        mem = new int[nums.length][2010];
        // 将备忘录数组所有元素初始化为-1,表示未计算过
        for (int i = 0; i < nums.length; i++) Arrays.fill(mem[i], -1);
        // 调用递归函数,返回符合条件的方案数
        return dfs(nums.length - 1, 0, target, nums);
    }

    // 备忘录数组,用于记录计算结果
    int[][] mem;

    // 递归函数,计算从第idx个数到第0个数的方案数
    private int dfs(int idx, int sum, int target, int[] nums) {
        // 如果idx小于0,表示已经遍历完所有数,返回1或0(取决于sum是否等于target)
        if (idx < 0) return sum == target ? 1 : 0;
        // 如果备忘录中已经计算过该索引位置的结果,则直接返回备忘录中的结果
        if (mem[idx][sum + 1000] != -1) return mem[idx][sum + 1000];

        // 计算选择+和选择-两种情况下的方案数之和
        int ans = dfs(idx - 1, sum + nums[idx], target, nums) +
                  dfs(idx - 1, sum - nums[idx], target, nums);

        // 将计算得到的方案数存入备忘录数组中
        mem[idx][sum + 1000] = ans;

        return ans;
    }
}
class Solution:
    def findTargetSumWays(self, nums: List[int], target: int) -> int:
        @cache
        def dfs(idx, Sum):
            if idx == len(nums):
                return 1 if Sum == target else 0
            return dfs(idx + 1, Sum + nums[idx]) + dfs(idx + 1, Sum - nums[idx])

        return dfs(0, 0)
最小路径和
给定一个包含非负整数的 m x n 网格 grid ,请找出一条从左上角到右下角的路径,使得路径上的数字总和为最小。
说明:每次只能向下或者向右移动一步。
示例 1:
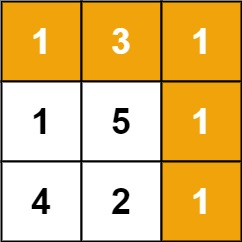
输入:grid = [[1,3,1],[1,5,1],[4,2,1]]
输出:7
解释:因为路径 1→3→1→1→1 的总和最小。
示例 2:
输入:grid = [[1,2,3],[4,5,6]]
输出:12
提示:
m == grid.length
n == grid[i].length
1 <= m, n <= 200
0 <= grid[i][j] <= 100
题目解析
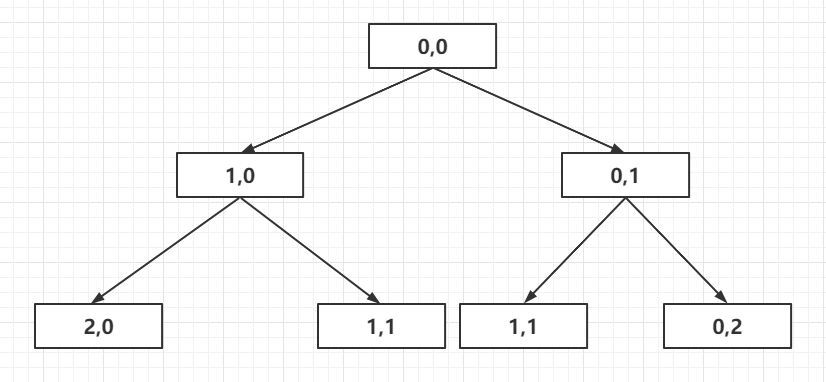
对于任意节点(i, j),每次可以走的方向只有两个,要么向下走,要么向右走。每次取最小值即可。式子如下:
f(i, j) = min(f(i + 1, j), f(i, j + 1)) + grid[i][j]
代码展示
class Solution {

    // minPathSum 方法用于计算网格 grid 从左上角到右下角的最小路径和
    // 只能向下或向右移动
    public int minPathSum(int[][] grid) {
        // 获取网格的行数和列数
        int row = grid.length;
        int col = grid[0].length;

        // 初始化备忘录数组 mem,用于存储已经计算过的路径和,避免重复计算
        mem = new int[row][col];
        // 使用 Arrays.fill 方法将备忘录数组 mem 填入 -1,表示初始时未计算过
        for (int i = 0; i < row; i++) {
            Arrays.fill(mem[i], -1);
        }

        // 调用 dfs 方法从网格的左上角 (0, 0) 开始进行深度优先搜索
        return dfs(0, 0, row, col, grid);
    }

    // mem 备忘录数组,用于存储已经计算过的路径和
    int[][] mem;

    // dfs 方法是一个递归方法,用于计算从位置 (i, j) 开始到右下角的最小路径和
    private int dfs(int i, int j, int row, int col, int[][] grid) {
        // 判断是否到达右下角
        if (i == row - 1 && j == col - 1) {
            // 如果到达右下角,返回该位置的值
            return grid[i][j];
        }
        // 如果当前位置超出网格范围,则返回一个足够大的数,表示不可达
        if (i < 0 || j < 0 || i >= row || j >= col) {
            return 1000000;
        }
        // 如果备忘录中已经计算过当前位置的路径和,则直接返回
        if (mem[i][j] != -1) {
            return mem[i][j];
        }

        // 计算向右移动的路径和,即不包括当前格子的值,加上当前格子的值
        int right = dfs(i, j + 1, row, col, grid) + grid[i][j];
        // 计算向下移动的路径和
        int down = dfs(i + 1, j, row, col, grid) + grid[i][j];

        // 取向右和向下两条路径的较小值,并存储到备忘录中
        int ans = Math.min(right, down);
        mem[i][j] = ans;

        // 返回当前位置的最小路径和
        return ans;
    }
}
class Solution:
def minPathSum(self, grid: List[List[int]]) -> int:
m, n = len(grid), len(grid[0])
@cache
def dfs(x, y):
if x == m - 1 and y == n - 1: return grid[x][y]
if x >= m or y >= n: return 2000000
return min(dfs(x + 1, y), dfs(x, y + 1)) + grid[x][y]
return dfs(0, 0)
不同路径
一个机器人位于一个 m x n 网格的左上角 (起始点在下图中标记为 “Start” )。
机器人每次只能向下或者向右移动一步。机器人试图达到网格的右下角(在下图中标记为 “Finish” )。
问总共有多少条不同的路径?
示例 1:
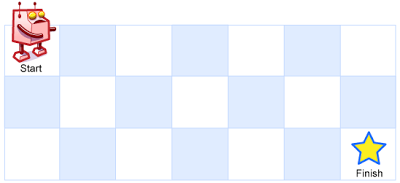
输入:m = 3, n = 7
输出:28
示例 2:
输入:m = 3, n = 2
输出:3
解释:
从左上角开始,总共有 3 条路径可以到达右下角。
1.向右 -> 向下 -> 向下
2.向下 -> 向下 -> 向右
3.向下 -> 向右 -> 向下
示例 3:
输入:m = 7, n = 3
输出:28
示例 4:
输入:m = 3, n = 3
输出:6
提示:
1 <= m, n <= 100
题目数据保证答案小于等于 2 * 10^9
题目解析
递归思路如下:每次可以选择向下走和向右走。求总和即可。式子如下:
f(i, j) = f(i + 1, j) + f(i, j + 1)
代码展示
class Solution {
    // 定义一个二维数组用于记忆化搜索,初始值设为-1表示未计算过
    int[][] mem;

    /**
     * 计算从左上角到右下角有多少种不同的路径。
     * @param m 目标网格的行数
     * @param n 目标网格的列数
     * @return 不同路径的数量
     */
    public int uniquePaths(int m, int n) {
        // 初始化记忆化搜索的二维数组,大小为(m+1) x (n+1),预留一位用于处理边界情况
        mem = new int[m + 1][n + 1];

        // 将数组所有元素初始化为-1,表示尚未计算
        for (int i = 0 ; i <= m ; i++) {
            Arrays.fill(mem[i], -1 );
        }

        // 从起点(0, 0)开始进行深度优先搜索计算不同路径数量
        return dfs(0, 0, m, n);
    }

    /**
     * 深度优先搜索计算从(i, j)到(m-1, n-1)的不同路径数量。
     * 利用记忆化递归减少重复计算。
     * @param i 当前所在的行
     * @param j 当前所在的列
     * @param m 目标网格的行数
     * @param n 目标网格的列数
     * @return 从当前位置到终点的不同路径数量
     */
    private int dfs(int i, int j, int m, int n) {
        // 如果到达终点,返回1表示找到一种路径
        if (i == m - 1 && j == n - 1) {
            return 1;
        }

        // 如果越界,返回0表示此路径无效
        if (i < 0 || j < 0 || i >= m || j >= n) {
            return 0;
        }

        // 如果当前位置的结果已经计算过,直接从记忆数组中返回结果
        if (mem[i][j] != -1) {
            return mem[i][j];
        }

        // 向下和向右两个方向探索,累加两种情况下的路径数量
        int ans =  dfs(i + 1, j, m, n) + dfs(i, j + 1, m, n);

        // 将计算结果存入记忆数组,避免重复计算
        mem[i][j] = ans;

        // 返回计算结果
        return ans;
    }
}
class Solution:
def uniquePaths(self, m: int, n: int) -> int:
@cache
def dfs(x, y):
if x == m - 1 and y == n - 1: return 1
if x == m or y == n: return 0
return dfs(x + 1, y) + dfs(x, y + 1)
return dfs(0, 0)不同路径 II
一个机器人位于一个 m x n 网格的左上角 (起始点在下图中标记为 “Start” )。
机器人每次只能向下或者向右移动一步。机器人试图达到网格的右下角(在下图中标记为 “Finish”)。
现在考虑网格中有障碍物。那么从左上角到右下角将会有多少条不同的路径?
网格中的障碍物和空位置分别用 1 和 0 来表示。
示例 1:
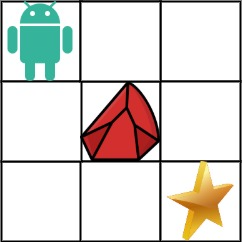
输入:obstacleGrid = [[0,0,0],[0,1,0],[0,0,0]]
输出:2
解释:3x3 网格的正中间有一个障碍物。
从左上角到右下角一共有 2 条不同的路径:
1.向右 -> 向右 -> 向下 -> 向下
2.向下 -> 向下 -> 向右 -> 向右
示例 2:
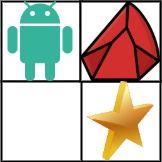
输入:obstacleGrid = [[0,1],[0,0]]
输出:1
提示:
m == obstacleGrid.length
n == obstacleGrid[i].length
1 <= m, n <= 100
obstacleGrid[i][j] 为 0 或 1
题目解析
每次递归可以走的方向有两种:1.向下走 2.向右走
当走到终点的时候说明有一种走法,返回1。如果走出边界或者遇到障碍物,说明此路不通,返回0。式子如下:
f(i, j) = f(i + 1, j) + f(i, j + 1)
代码展示
class Solution {

    // uniquePathsWithObstacles 方法用于计算在给定的有障碍物的网格中,从左上角到右下角的唯一路径数量
    public int uniquePathsWithObstacles(int[][] obstacleGrid) {
        // 获取网格的行数 m 和列数 n
        int m = obstacleGrid.length, n = obstacleGrid[0].length;
        // 初始化备忘录数组 mem,用于存储已经计算过的路径数量,避免重复计算
        mem = new int[m][n];
        // 使用 Arrays.fill 方法将备忘录数组 mem 填入 -1,表示初始时未计算过
        for (int i = 0; i < m; i++) {
            Arrays.fill(mem[i], -1);
        }
        // 调用 dfs 方法从网格的左上角 (0, 0) 开始进行深度优先搜索
        return dfs(0, 0, m, n, obstacleGrid);
    }

    // mem 备忘录数组,用于存储已经计算过的位置的路径数量
    int[][] mem;

    // dfs 方法是一个递归方法,用于计算从位置 (i, j) 开始到右下角 (m - 1, n - 1) 的唯一路径数量
    private int dfs(int i, int j, int m, int n, int[][] obstacleGrid) {
        // 如果当前位置超出网格范围或存在障碍物,则无法通过,返回 0
        if (i < 0 || j < 0 || i >= m || j >= n || obstacleGrid[i][j] == 1) {
            return 0;
        }
        // 如果到达右下角,存在 1 条路径
        if (i == m - 1 && j == n - 1) {
            return 1;
        }
        // 如果备忘录中已经计算过当前位置的路径数量,则直接返回该值
        if (mem[i][j] != -1) {
            return mem[i][j];
        }
        // 否则,计算当前位置向下和向右两个方向的路径数量,并将它们相加
        // 将计算结果存储到备忘录中,然后返回
        int ans = dfs(i + 1, j, m, n, obstacleGrid) + dfs(i, j + 1, m, n, obstacleGrid);
        mem[i][j] = ans;
        return ans;
    }
}
class Solution:
def uniquePathsWithObstacles(self, obstacleGrid: List[List[int]]) -> int:
m, n = len(obstacleGrid), len(obstacleGrid[0])
@cache
def dfs(x, y):
if x == m - 1 and y == n - 1: return 1 if obstacleGrid[x][y] == 0 else 0
if x < 0 or y < 0 or x >= m or y >= n or obstacleGrid[x][y] == 1: return 0
return dfs(x + 1, y) + dfs(x, y + 1)
return dfs(0, 0)
单词拆分
给你一个字符串 s 和一个字符串列表 wordDict 作为字典。请你判断是否可以利用字典中出现的单词拼接出 s 。
注意:不要求字典中出现的单词全部都使用,并且字典中的单词可以重复使用。
示例 1:
输入: s = “leetcode”, wordDict = [“leet”, “code”]
输出: true
解释: 返回 true 因为 “leetcode” 可以由 “leet” 和 “code” 拼接成。
示例 2:
输入: s = “applepenapple”, wordDict = [“apple”, “pen”]
输出: true
解释: 返回 true 因为 “applepenapple” 可以由 “apple” “pen” “apple” 拼接成。
注意,你可以重复使用字典中的单词。
示例 3:
输入: s = “catsandog”, wordDict = [“cats”, “dog”, “sand”, “and”, “cat”]
输出: false
提示:
1 <= s.length <= 300
1 <= wordDict.length <= 1000
1 <= wordDict[i].length <= 20
s 和 wordDict[i] 仅有小写英文字母组成
wordDict 中的所有字符串 互不相同
题目解析
依然采用递归的思想进行分析。
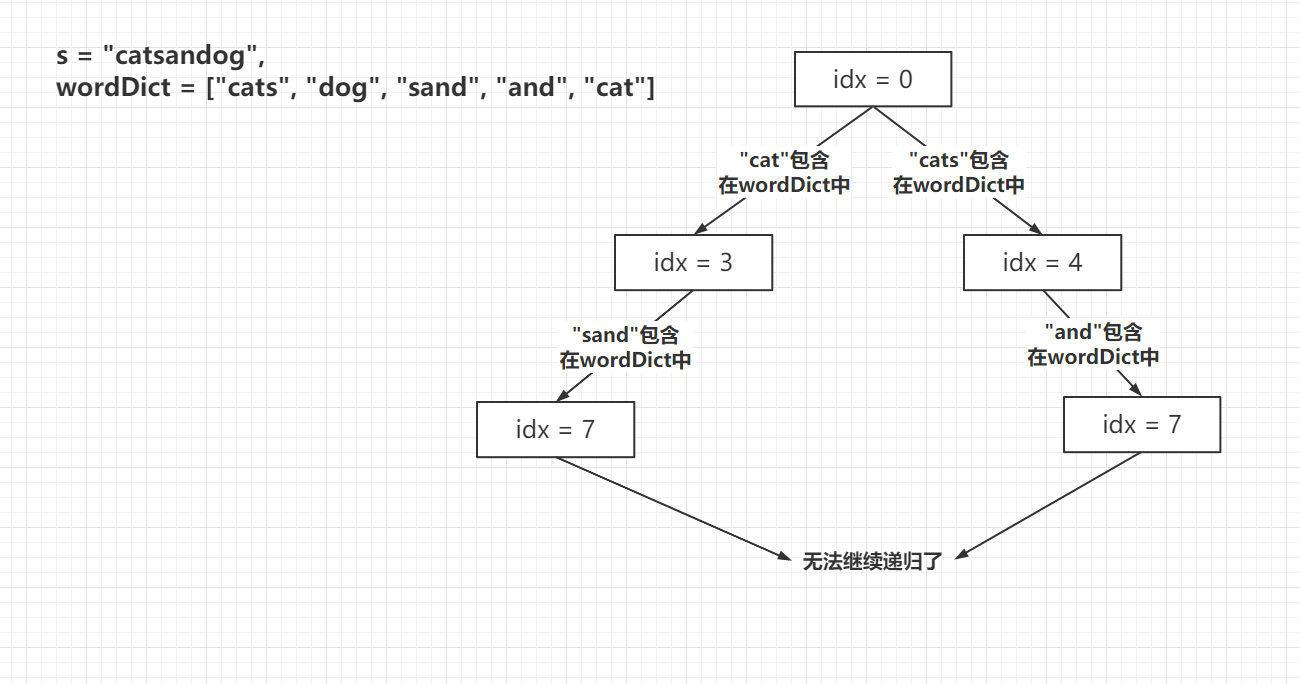
以样例1为例,s = “catsandog”, wordDict = [“cats”, “dog”, “sand”, “and”, “cat”]。我们从s的下标为0开始往后枚举,发现字符串”cat”,“cats”存在于wordDict中,因此可以进行递归, 下一次递归应该从下标为4也就是3和4开始。因此:
- 递归的参数:idx 从idx往后开始枚举
- 出口:如果idx到达s.length()后,说明s整段都可以用wordDict组成
- 方向:只要s.substring(idx, j)包含在wordDict中就可进行递归。
以下代码中的mem数组含义:mem[idx]表示的是s.substring(idx, s.length())是否可以由wordDict组成。初始值0表示这个状态还没算过,当mem[idx]==1的时候表示s.substring(idx, s.length())可以由wordDict组成;当mem[idx]==-1的时候表示不可以由wordDict组成。
代码展示
class Solution {
    // wordBreak 方法用于检查字符串 s 是否可以由 wordDict 词汇表中的单词组成
    public boolean wordBreak(String s, List<String> wordDict) {
        // 使用 HashSet 存储 wordDict 中的单词,以便快速查找
        HashSet<String> set = new HashSet<>(wordDict);
        // 初始化备忘录数组 mem,长度与字符串 s 相同
        mem = new int[s.length()];
        // 调用 dfs 方法从字符串 s 的索引 0 开始进行深度优先搜索
        return dfs(0, s, set);
    }

    // mem 备忘录数组,用于存储已经计算过的索引位置的结果,0 表示未知,1 表示 true,-1 表示 false
    int[] mem;

    // dfs 方法是一个递归方法,用于检查从索引 idx 开始的字符串 s 是否可以由 wordDict 词汇表中的单词组成
    private boolean dfs(int idx, String s, HashSet<String> set) {
        // 如果当前索引 idx 大于等于字符串 s 的长度,说明已经处理到字符串末尾,返回 true
        if (idx >= s.length()) {
            return true;
        }
        // 如果备忘录中已经计算过当前索引 idx 的结果,则直接返回该结果
        if (mem[idx] != 0) {
            return mem[idx] == 1;
        }
        // 初始化结果变量 ans 为 false
        boolean ans = false;
        // 从当前索引 idx 开始,遍历字符串 s,直到字符串结束
        for (int i = idx; i <= s.length(); i++) {
            // 使用 substring 方法获取从 idx 到 i 的子串
            String temp = s.substring(idx, i);
            // 如果 HashSet set 包含当前子串 temp,则递归检查从索引 i 开始的字符串 s 是否可以由 wordDict 词汇表中的单词组成
            // 并将结果累加到 ans 中
            if (set.contains(temp)) {
                ans = ans || dfs(i, s, set);
            }
        }
        // 将计算结果存储到备忘录数组 mem 中,如果 ans 为 true,则记为 1,否则记为 -1
        mem[idx] = ans ? 1 : -1;
        // 返回计算结果 ans
        return ans;
    }
}
class Solution:
def wordBreak(self, s: str, wordDict: List[str]) -> bool:
@cache
def dfs(s):
if len(s) == 0:
return True
res = False
for j in range(1,len( s) + 1):
if (s[:j] in wordDict):
res = dfs( s[j:]) or res
return res
return dfs(s)整数替换
给定一个正整数 n ,你可以做如下操作:
如果 n 是偶数,则用 n / 2 替换 n 。
如果 n 是奇数,则可以用 n + 1或n - 1替换 n 。
返回 n 变为 1 所需的 最小替换次数 。
示例 1:
输入:n = 8
输出:3
解释:8 -> 4 -> 2 -> 1
示例 2:
输入:n = 7
输出:4
解释:7 -> 8 -> 4 -> 2 -> 1
或 7 -> 6 -> 3 -> 2 -> 1
示例 3:
输入:n = 4
输出:2
提示:
1 <= n <= 2^31 - 1
题目解析
此题很明显可以使用递归来做,题目已经明确告诉我们递归的方向:如果n是偶数的话递归方向就是n / 2,如果是奇数的话应该是n + 1 和 n - 1。不难发现如果n是奇数,那么n - 1和n + 1是偶数,那么下一次递归方向就必然是 (n + 1) / 2 和 (n - 1) / 2,因此不难写出以下代码。
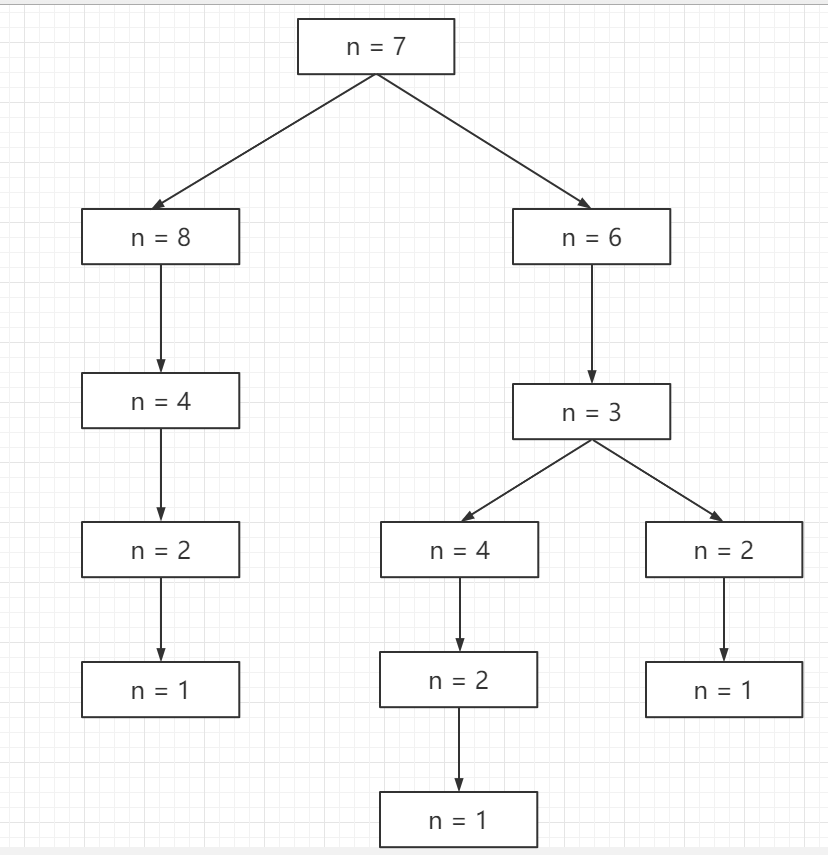
其中mem的含义是mem[n]:n变为1的最少操作数。
注意:这题如果采用自底向上的动态规划的式子如下:
if i % 2 == 0:
	dp[i] = dp[i / 2] + 1
else:
	dp[i] = min(dp[(i + 1)/2], dp[(i - 1)/2]) + 2
但是这样做的时间复杂度是O(n),而n的范围是2^31次方,所以是会超时的。采用递归的做法则是logn的复杂度,所以此题要使用递归的方式进行求解。
代码展示
class Solution {

    // integerReplacement 方法用于计算将整数 n 替换为 1 所需要的最小操作次数
    // 每次操作可以乘以 2 或减去 1
    public int integerReplacement(int n) {
        // 调用 dfs 方法开始计算,传入参数 n
        return dfs(n);
    }

    // mem 用于存储已经计算过的整数 n 的替换步数,避免重复计算
    HashMap<Integer, Integer> mem = new HashMap<>();

    // dfs 方法是一个递归方法,用于计算将整数 n 替换为 1 所需的最小操作步数
    private int dfs(int n) {
        // 如果整数 n 已经为 1,则不需要任何操作,返回 0
        if (n == 1) {
            return 0;
        }
        // 如果已经计算过整数 n 的替换步数,则直接从 mem 中获取结果
        if (mem.containsKey(n)) {
            return mem.get(n);
        }
        int ans = 0; // 初始化答案变量 ans
        // 如果整数 n 是偶数,则可以除以 2,操作步数为 dfs(n / 2) + 1
        if (n % 2 == 0) {
            ans = dfs(n / 2) + 1;
        } else {
            // 如果整数 n 是奇数,则可以选择减去 1 或加上 1 使其变为偶数,取两种方式的最小操作步数
            // 操作步数为 Math.min(dfs((n - 1) / 2), dfs((n + 1) / 2)) + 2
            ans = Math.min(dfs((n - 1) / 2), dfs((n + 1) / 2)) + 2;
        }
        // 将计算得到的操作步数存入 mem,键为 n,值为 ans
        mem.put(n, ans);
        // 返回整数 n 的替换操作步数 ans
        return ans;
    }
}
class Solution:
def integerReplacement(self, n: int) -> int:
@cache
def dfs(cur):
if cur == 1: return 0
if cur % 2 == 0:
return dfs(cur // 2) + 1
return min(dfs(cur + 1), dfs(cur - 1)) + 1
return dfs(n)跳跃游戏
给定一个非负整数数组 nums ,你最初位于数组的 第一个下标 。
数组中的每个元素代表你在该位置可以跳跃的最大长度。
判断你是否能够到达最后一个下标。
示例 1:
输入:nums = [2,3,1,1,4]
输出:true
解释:可以先跳 1 步,从下标 0 到达下标 1, 然后再从下标 1 跳 3 步到达最后一个下标。
示例 2:
输入:nums = [3,2,1,0,4]
输出:false
解释:无论怎样,总会到达下标为 3 的位置。但该下标的最大跳跃长度是 0 , 所以永远不可能到达最后一个下标。
提示:
1 <= nums.length <= 3 * 10^4
0 <= nums[i] <= 10^5
题目解析
解法1——记忆化搜索
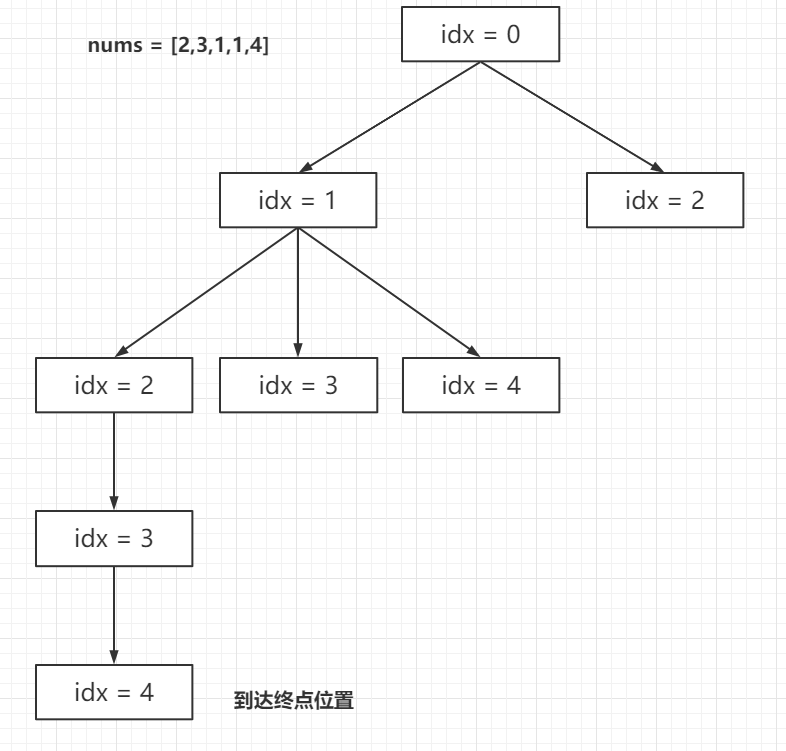
递归的思路:从下标为0开始走,可以往后走的步数为[1, nums[0]],每个走法都去尝试一次,因此我们可以设计出如下递归函数:
- 递归参数:idx表示当前位置
- 递归出口:当走到走后一个位置的时候return true
- 递归方向:idx + j , j ∈[1,nums[idx]]
mem[idx] = 0表示idx这个位置还没走过
mem[idx] = 1表示这个位置可以走到末尾
mem[idx] = -1表示走不到
解法2——贪婪算法
此题可以用贪心算法进行解答,后面贪心算法的模块我们再来讲解。
代码展示
class Solution {

    // canJump 方法用于判断给定的数组 nums 是否可以通过跳跃到达最后一个位置
    public boolean canJump(int[] nums) {
        // 初始化备忘录数组 mem,长度与 nums 相同,所有元素初始化为 0
        mem = new int[nums.length];
        // 从索引 0 开始调用 dfs 方法进行深度优先搜索
        return dfs(0, nums);
    }

    // mem 备忘录数组,用于存储已经计算过的索引位置的结果,0 表示未计算,1 表示可到达,-1 表示不可到达
    int[] mem;

    // dfs 方法是一个递归方法,用于判断从索引 idx 开始的位置是否可以到达数组的最后一个位置
    private boolean dfs(int idx, int[] nums) {
        // 如果当前索引 idx 已经到达或超过数组的末尾,则认为可以到达最后一个位置
        if (idx >= nums.length - 1) {
            return true;
        }
        // 如果备忘录中已经计算过当前索引 idx 的结果,则直接返回结果
        if (mem[idx] != 0) {
            return mem[idx] == 1;
        }
        // 遍历当前索引 idx 可以跳跃到达的所有可能位置
        for (int i = 1; i <= nums[idx]; i++) {
            // 如果从 idx + i 的位置可以到达最后一个位置,则将 mem[idx] 设置为 1 并返回 true
            if (dfs(idx + i, nums)) {
                mem[idx] = 1;
                return true;
            }
        }
        // 如果以上跳跃位置都无法到达最后一个位置,则将 mem[idx] 设置为 -1 并返回 false
        mem[idx] = -1;
        return false;
    }
}
class Solution:
def canJump(self, nums: List[int]) -> bool:
@cache
def dfs(i):
if i >= len(nums) -1: return True
for j in range(1, nums[i]+1):
if dfs(i+j): return True
return False
return dfs(0)跳跃游戏 II
给你一个非负整数数组 nums ,你最初位于数组的第一个位置。
数组中的每个元素代表你在该位置可以跳跃的最大长度。
你的目标是使用最少的跳跃次数到达数组的最后一个位置。
假设你总是可以到达数组的最后一个位置。
示例 1:
输入: nums = [2,3,1,1,4]
输出: 2
解释: 跳到最后一个位置的最小跳跃数是 2。
从下标为 0 跳到下标为 1 的位置,跳 1 步,然后跳 3 步到达数组的最后一个位置。
示例 2:
输入: nums = [2,3,0,1,4]
输出: 2
提示:
1 <= nums.length <= 104
0 <= nums[i] <= 1000
题目解析
递归的思路如下:
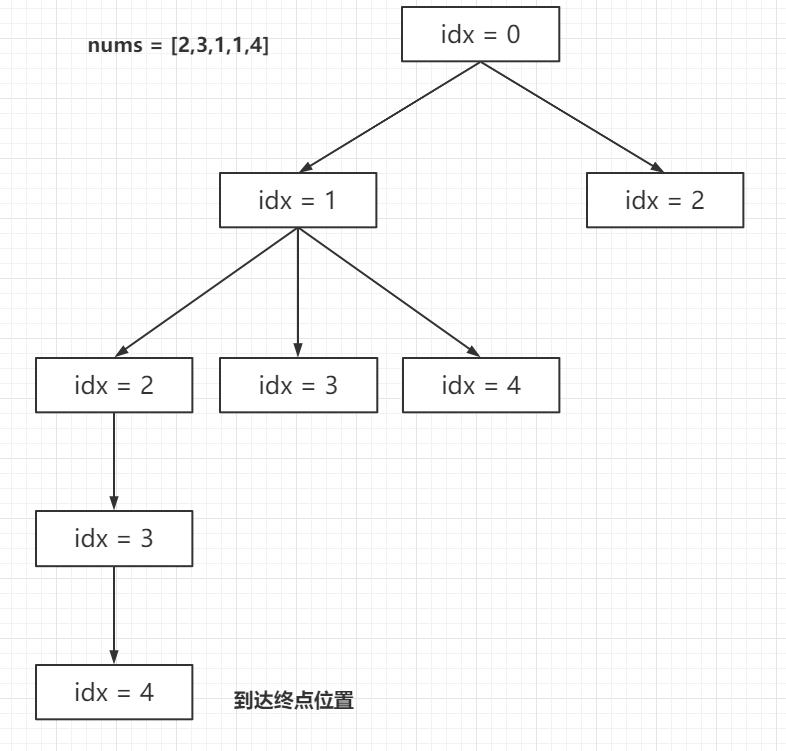
从下标为 idx 往后走,可以走的台阶数是 idx + j , 其中 j∈[1,nums[idx]] ,各个方向中我们需要选取最小值。
递归的三个核心如下:
- 递归参数:
idx表示当前所在的台阶 - 递归出口:当走到最后一个台阶的时候返回
- 递归方向:
idx + j, 其中j∈[1,nums[idx]],每次取最小值即可。
代码展示
class Solution {

    // jump 方法用于计算数组 nums 中到达最后一个位置的最少跳跃次数
    public int jump(int[] nums) {
        // 初始化备忘录数组 mem,长度与 nums 相同,所有元素初始化为 -1 表示未计算
        mem = new int[nums.length];
        Arrays.fill(mem, -1);
        // 从索引 0 开始调用 dfs 方法进行深度优先搜索,计算到达数组末尾的最少跳跃次数
        return dfs(0, nums);
    }

    // mem 备忘录数组,用于存储每个索引到达数组末尾所需的最少跳跃次数
    int[] mem;

    // dfs 方法是一个递归方法,用于计算从索引 idx 开始到达数组末尾的最少跳跃次数
    private int dfs(int idx, int[] nums) {
        // 如果当前索引 idx 已经到达或超过数组的末尾,则无需跳跃,返回 0
        if (idx >= nums.length - 1) {
            return 0;
        }
        // 如果备忘录中已经计算过当前索引 idx 的跳跃次数,则直接返回该值
        if (mem[idx] != -1) {
            return mem[idx];
        }
        // 初始化 ans 为一个较大的数,用于存储当前索引到达末尾的最小跳跃次数
        int ans = 10000010;
        // 遍历当前索引 idx 可以跳跃到达的所有可能位置
        for (int i = 1; i <= nums[idx]; i++) {
            // 对于每个可以跳跃到达的位置,计算从该位置到达末尾的最少跳跃次数,并加上当前步的 1 次跳跃
            // 使用 Math.min 更新 ans 为到达末尾的全局最小跳跃次数
            ans = Math.min(ans, dfs(idx + i, nums) + 1);
        }
        // 将计算得到的最小跳跃次数存储到备忘录 mem 中
        mem[idx] = ans;
        // 返回当前索引 idx 到达末尾的最少跳跃次数
        return ans;
    }
}
class Solution:
def jump(self, nums: List[int]) -> int:
@cache
def dfs(i):
if i >= len(nums) - 1: return 0
ans = inf
for j in range(1, nums[i]+1):
ans = min(ans, dfs(i+j) + 1)
return ans
return dfs(0)