常见的查找算法与排序算法
1 常见的七种查找算法
1.1 基本查找
也叫做顺序查找。说明:顺序查找适合于存储结构为数组或者链表。
基本思想:顺序查找也称为线形查找,属于无序查找算法。从数据结构线的一端开始,顺序扫描,依次将遍历到的结点与要查找的值相比较,若相等则表示查找成功;若遍历结束仍没有找到相同的,表示查找失败。
示例代码:
public class A01_BasicSearchDemo1 {
    public static void main(String[] args) {
        //基本查找/顺序查找
        //核心:
        //从0索引开始挨个往后查找

        //需求:定义一个方法利用基本查找,查询某个元素是否存在
        //数据如下:{131, 127, 147, 81, 103, 23, 7, 79}
        int[] arr = {131, 127, 147, 81, 103, 23, 7, 79};
        int number = 82;
        System.out.println(basicSearch(arr, number));

    }

    //参数:
    //一:数组
    //二:要查找的元素

    //返回值:
    //元素是否存在
    public static boolean basicSearch(int[] arr, int number){
        //利用基本查找来查找number在数组中是否存在
        for (int i = 0; i < arr.length; i++) {
            if(arr[i] == number){
                return true;
            }
        }
        return false;
    }
}
1.2 二分查找
也叫做折半查找
说明:元素必须是有序的,从小到大,或者从大到小都是可以的。
如果是无序的,也可以先进行排序。但是排序之后,会改变原有数据的顺序,查找出来元素位置跟原来的元素可能是不一样的,所以排序之后再查找只能判断当前数据是否在容器当中,返回的索引无实际的意义。
基本思想:也称为是折半查找,属于有序查找算法。用给定值先与中间结点比较。比较完之后有三种情况:
-
相等:说明找到了
-
要查找的数据比中间节点小:说明要查找的数字在中间节点左边
-
要查找的数据比中间节点大:说明要查找的数字在中间节点右边
代码示例:
package com.itheima.search;

public class A02_BinarySearchDemo1 {
    public static void main(String[] args) {
        //二分查找/折半查找
        //核心:
        //每次排除一半的查找范围

        //需求:定义一个方法利用二分查找,查询某个元素在数组中的索引
        //数据如下:{7, 23, 79, 81, 103, 127, 131, 147}
        int[] arr = {7, 23, 79, 81, 103, 127, 131, 147};
        System.out.println(binarySearch(arr, 150));
    }

    public static int binarySearch(int[] arr, int number){
        //1.定义两个变量记录要查找的范围
        int min = 0;
        int max = arr.length - 1;

        //2.利用循环不断的去找要查找的数据
        while(true){
            if(min > max){
                return -1;
            }
            //3.找到min和max的中间位置
            int mid = (min + max) / 2;
            //4.拿着mid指向的元素跟要查找的元素进行比较
            if(arr[mid] > number){
                //4.1 number在mid的左边
                //min不变,max = mid - 1;
                max = mid - 1;
            }else if(arr[mid] < number){
                //4.2 number在mid的右边
                //max不变,min = mid + 1;
                min = mid + 1;
            }else{
                //4.3 number跟mid指向的元素一样
                //找到了
                return mid;
            }

        }
    }
}
1.3 插值查找
在介绍插值查找之前,先考虑一个问题:
为什么二分查找算法一定要是折半,而不是折四分之一或者折更多呢?
其实就是因为方便,简单,但是如果我能在二分查找的基础上,让中间的mid点,尽可能靠近想要查找的元素,那不就能提高查找的效率了吗?
二分查找中查找点计算如下:
mid=(low+high)/2, 即mid=low+1/2*(high-low);
我们可以将查找的点改进为如下:
mid=low+(key-a[low])/(a[high]-a[low])*(high-low)
这样,让mid值的变化更靠近关键字key,这样也就间接地减少了比较次数。
基本思想:基于二分查找算法,将查找点的选择改进为自适应选择,可以提高查找效率。当然,差值查找也属于有序查找。
**细节:**对于表长较大,而关键字分布又比较均匀的查找表来说,插值查找算法的平均性能比折半查找要好的多。反之,数组中如果分布非常不均匀,那么插值查找未必是很合适的选择。
代码跟二分查找类似,只要修改一下mid的计算方式即可。
1.4 斐波那契查找
在介绍斐波那契查找算法之前,我们先介绍一下很它紧密相连并且大家都熟知的一个概念——黄金分割。
黄金比例又称黄金分割,是指事物各部分间一定的数学比例关系,即将整体一分为二,较大部分与较小部分之比等于整体与较大部分之比,其比值约为1:0.618或1.618:1。
0.618被公认为最具有审美意义的比例数字,这个数值的作用不仅仅体现在诸如绘画、雕塑、音乐、建筑等艺术领域,而且在管理、工程设计等方面也有着不可忽视的作用。因此被称为黄金分割。
在数学中有一个非常有名的数学规律:斐波那契数列:1, 1, 2, 3, 5, 8, 13, 21, 34, 55, 89…….
(从第三个数开始,后边每一个数都是前两个数的和)。
然后我们会发现,随着斐波那契数列的递增,前后两个数的比值会越来越接近0.618,利用这个特性,我们就可以将黄金比例运用到查找技术中。
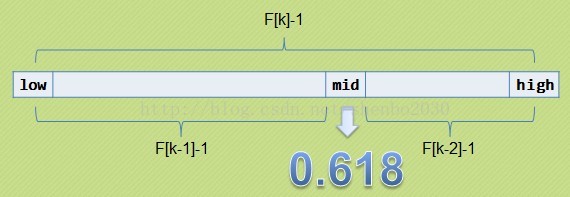
基本思想:也是二分查找的一种提升算法,通过运用黄金比例的概念在数列中选择查找点进行查找,提高查找效率。同样地,斐波那契查找也属于一种有序查找算法。
斐波那契查找也是在二分查找的基础上进行了优化,优化中间点mid的计算方式即可
代码示例:
public class FeiBoSearchDemo {
    public static int maxSize = 20;

    public static void main(String[] args) {
        int[] arr = {1, 8, 10, 89, 1000, 1234};
        System.out.println(search(arr, 1234));
    }

    public static int[] getFeiBo() {
        int[] arr = new int[maxSize];
        arr[0] = 1;
        arr[1] = 1;
        for (int i = 2; i < maxSize; i++) {
            arr[i] = arr[i - 1] + arr[i - 2];
        }
        return arr;
    }

    public static int search(int[] arr, int key) {
        int low = 0;
        int high = arr.length - 1;
        //表示斐波那契数分割数的下标值
        int index = 0;
        int mid = 0;
        //调用斐波那契数列
        int[] f = getFeiBo();
        //获取斐波那契分割数值的下标
        while (high > (f[index] - 1)) {
            index++;
        }
        //因为f[k]值可能大于a的长度,因此需要使用Arrays工具类,构造一个新法数组,并指向temp[],不足的部分会使用0补齐
        int[] temp = Arrays.copyOf(arr, f[index]);
        //实际需要使用arr数组的最后一个数来填充不足的部分
        for (int i = high + 1; i < temp.length; i++) {
            temp[i] = arr[high];
        }
        //使用while循环处理,找到key值
        while (low <= high) {
            mid = low + f[index - 1] - 1;
            if (key < temp[mid]) {//向数组的前面部分进行查找
                high = mid - 1;
                /*
                  对k--进行理解
                  1.全部元素=前面的元素+后面的元素
                  2.f[k]=k[k-1]+f[k-2]
                  因为前面有k-1个元素没所以可以继续分为f[k-1]=f[k-2]+f[k-3]
                  即在f[k-1]的前面继续查找k--
                  即下次循环,mid=f[k-1-1]-1
                 */
                index--;
            } else if (key > temp[mid]) {//向数组的后面的部分进行查找
                low = mid + 1;
                index -= 2;
            } else {//找到了
                //需要确定返回的是哪个下标
                if (mid <= high) {
                    return mid;
                } else {
                    return high;
                }
            }
        }
        return -1;
    }
}
1.5 分块查找
当数据表中的数据元素很多时,可以采用分块查找。
汲取了顺序查找和折半查找各自的优点,既有动态结构,又适于快速查找
分块查找适用于数据较多,但是数据不会发生变化的情况,如果需要一边添加一边查找,建议使用哈希查找。
分块查找的过程:
- 需要把数据分成N多小块,块与块之间不能有数据重复的交集;
- 给每一块创建对象单独存储到数组当中;
- 查找数据的时候,先在数组查,当前数据属于哪一块;
- 再到这一块中顺序查找。
代码示例:
package com.itheima.search;

public class A03_BlockSearchDemo {
    public static void main(String[] args) {
        /*
            分块查找
            核心思想:
                块内无序,块间有序
            实现步骤:
                1.创建数组blockArr存放每一个块对象的信息
                2.先查找blockArr确定要查找的数据属于哪一块
                3.再单独遍历这一块数据即可
        */
        int[] arr = {16, 5, 9, 12,21, 18,
                     32, 23, 37, 26, 45, 34,
                     50, 48, 61, 52, 73, 66};
        //创建三个块的对象
        Block b1 = new Block(21,0,5);
        Block b2 = new Block(45,6,11);
        Block b3 = new Block(73,12,17);

        //定义数组用来管理三个块的对象(索引表)
        Block[] blockArr = {b1,b2,b3};
        //定义一个变量用来记录要查找的元素
        int number = 37;
        //调用方法,传递索引表,数组,要查找的元素
        int index = getIndex(blockArr,arr,number);
        //打印一下
        System.out.println(index);
    }

    //利用分块查找的原理,查询number的索引
    private static int getIndex(Block[] blockArr, int[] arr, int number) {
        //1.确定number是在那一块当中
        int indexBlock = findIndexBlock(blockArr, number);

        if(indexBlock == -1){
            //表示number不在数组当中
            return -1;
        }

        //2.获取这一块的起始索引和结束索引   --- 30
        // Block b1 = new Block(21,0,5);   ----  0
        // Block b2 = new Block(45,6,11);  ----  1
        // Block b3 = new Block(73,12,17); ----  2
        int startIndex = blockArr[indexBlock].getStartIndex();
        int endIndex = blockArr[indexBlock].getEndIndex();

        //3.遍历
        for (int i = startIndex; i <= endIndex; i++) {
            if(arr[i] == number){
                return i;
            }
        }
        return -1;
    }

    //定义一个方法,用来确定number在哪一块当中
    public static int findIndexBlock(Block[] blockArr,int number){ //100
        //从0索引开始遍历blockArr,如果number小于max,那么就表示number是在这一块当中的
        for (int i = 0; i < blockArr.length; i++) {
            if(number <= blockArr[i].getMax()){
                return i;
            }
        }
        return -1;
    }

}

class Block{
    private int max;//最大值
    private int startIndex;//起始索引
    private int endIndex;//结束索引


    public Block() {
    }

    public Block(int max, int startIndex, int endIndex) {
        this.max = max;
        this.startIndex = startIndex;
        this.endIndex = endIndex;
    }

    /**
     * 获取
     * @return max
     */
    public int getMax() {
        return max;
    }

    /**
     * 设置
     * @param max
     */
    public void setMax(int max) {
        this.max = max;
    }

    /**
     * 获取
     * @return startIndex
     */
    public int getStartIndex() {
        return startIndex;
    }

    /**
     * 设置
     * @param startIndex
     */
    public void setStartIndex(int startIndex) {
        this.startIndex = startIndex;
    }

    /**
     * 获取
     * @return endIndex
     */
    public int getEndIndex() {
        return endIndex;
    }

    /**
     * 设置
     * @param endIndex
     */
    public void setEndIndex(int endIndex) {
        this.endIndex = endIndex;
    }

    public String toString() {
        return "Block{max = " + max + ", startIndex = " + startIndex + ", endIndex = " + endIndex + "}";
    }
}
1.6 哈希查找
哈希查找是分块查找的进阶版,适用于数据一边添加一边查找的情况。
一般是数组 + 链表的结合体或者是数组+链表 + 红黑树的结合体
在课程中,为了让大家方便理解,所以规定:
- 数组的0索引处存储1~100
- 数组的1索引处存储101~200
- 数组的2索引处存储201~300
- 以此类推
但是实际上,我们一般不会采取这种方式,因为这种方式容易导致一块区域添加的元素过多,导致效率偏低。
更多的是先计算出当前数据的哈希值,用哈希值跟数组的长度进行计算,计算出应存入的位置,再挂在数组的后面形成链表,如果挂的元素太多而且数组长度过长,我们也会把链表转化为红黑树,进一步提高效率。
1.7 树表查找
本知识点涉及到数据结构:树。
基本思想:二叉查找树是先对待查找的数据进行生成树,确保树的左分支的值小于右分支的值,然后在就行和每个节点的父节点比较大小,查找最适合的范围。 这个算法的查找效率很高,但是如果使用这种查找方法要首先创建树。
二叉查找树(BinarySearch Tree,也叫二叉搜索树,或称二叉排序树Binary Sort Tree),具有下列性质的二叉树:
1)若任意节点左子树上所有的数据,均小于本身;
2)若任意节点右子树上所有的数据,均大于本身;
二叉查找树性质:对二叉查找树进行中序遍历,即可得到有序的数列。
不同形态的二叉查找树如下图所示:
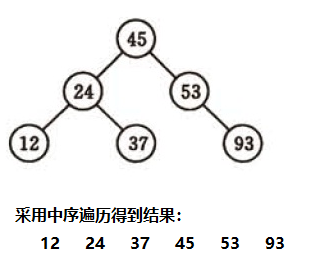
基于二叉查找树进行优化,进而可以得到其他的树表查找算法,如平衡树、红黑树等高效算法。
2 十大排序算法
2.1 概括
所谓排序,就是使一串记录,按照其中的某个或某些关键字的大小,递增或递减的排列起来的操作。排序算法,就是如何使得记录按照要求排列的方法。排序算法在很多领域得到相当地重视,尤其是在大量数据的处理方面。一个优秀的算法可以节省大量的资源。在各个领域中考虑到数据的各种限制和规范,要得到一个符合实际的优秀算法,得经过大量的推理和分析。
排序算法可以分为:
- 内部排序:数据记录在内存中进行排序。
- 外部排序 open in new window:因排序的数据很大,一次不能容纳全部的排序记录,在排序过程中需要访问外存。
常见的内部排序算法有:插入排序、希尔排序、选择排序、冒泡排序、归并排序、快速排序、堆排序、基数排序等,本文只讲解内部排序算法。用一张图概括:
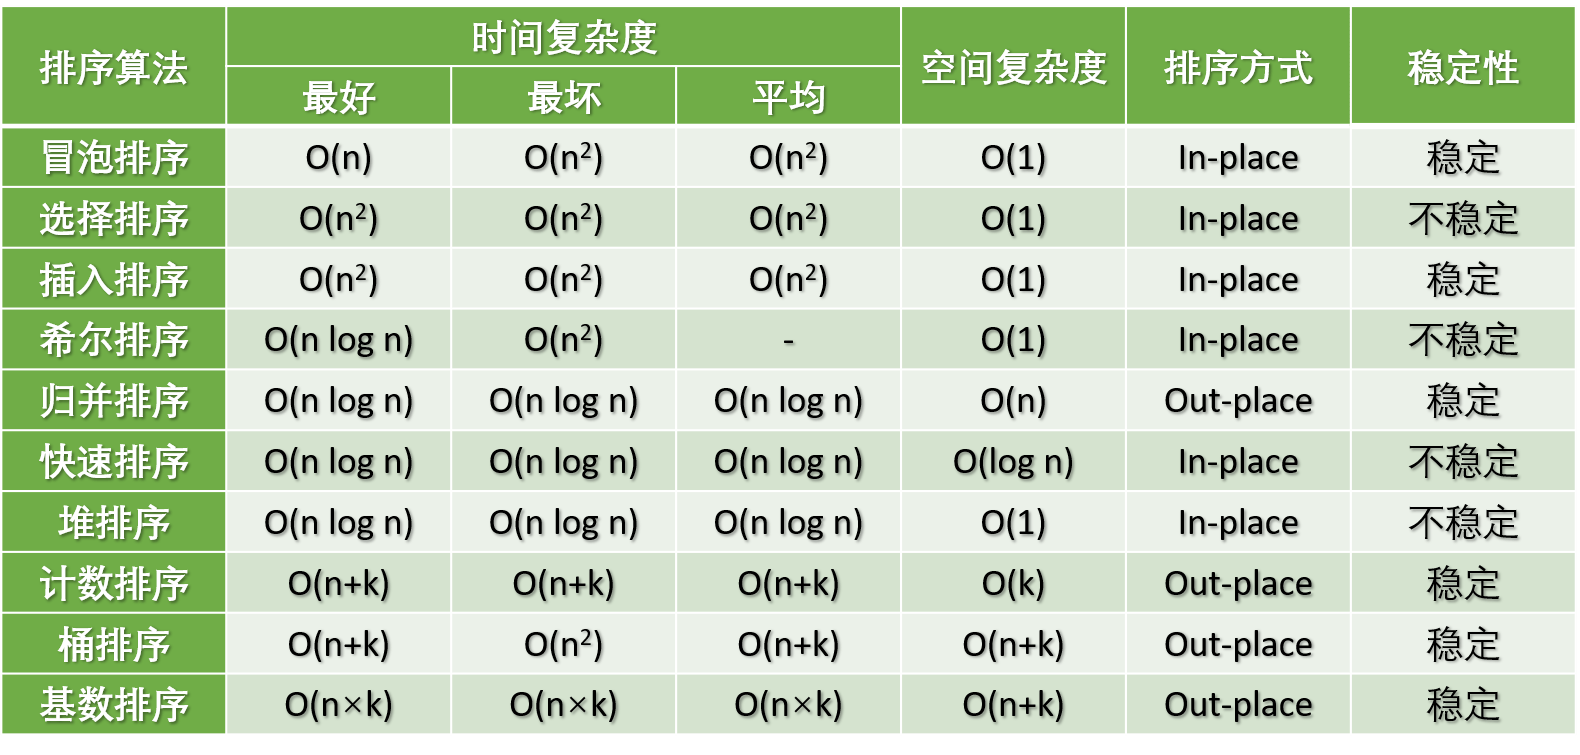
十大排序算法
上图存在错误:
- 插入排序的最好时间复杂度为 而不是 。
- 希尔排序的平均时间复杂度为 。
图片名词解释
- n:数据规模
- k:“桶” 的个数
- In-place:占用常数内存,不占用额外内存
- Out-place:占用额外内存
术语说明
- 稳定:如果 A 原本在 B 前面,而 ,排序之后 A 仍然在 B 的前面。
- 不稳定:如果 A 原本在 B 的前面,而 ,排序之后 A 可能会出现在 B 的后面。
- 内排序:所有排序操作都在内存中完成。
- 外排序:由于数据太大,因此把数据放在磁盘中,而排序通过磁盘和内存的数据传输才能进行。
- 时间复杂度:定性描述一个算法执行所耗费的时间。
- 空间复杂度:定性描述一个算法执行所需内存的大小。
2.2 算法分类
十种常见排序算法可以分类两大类别:比较类排序和非比较类排序。
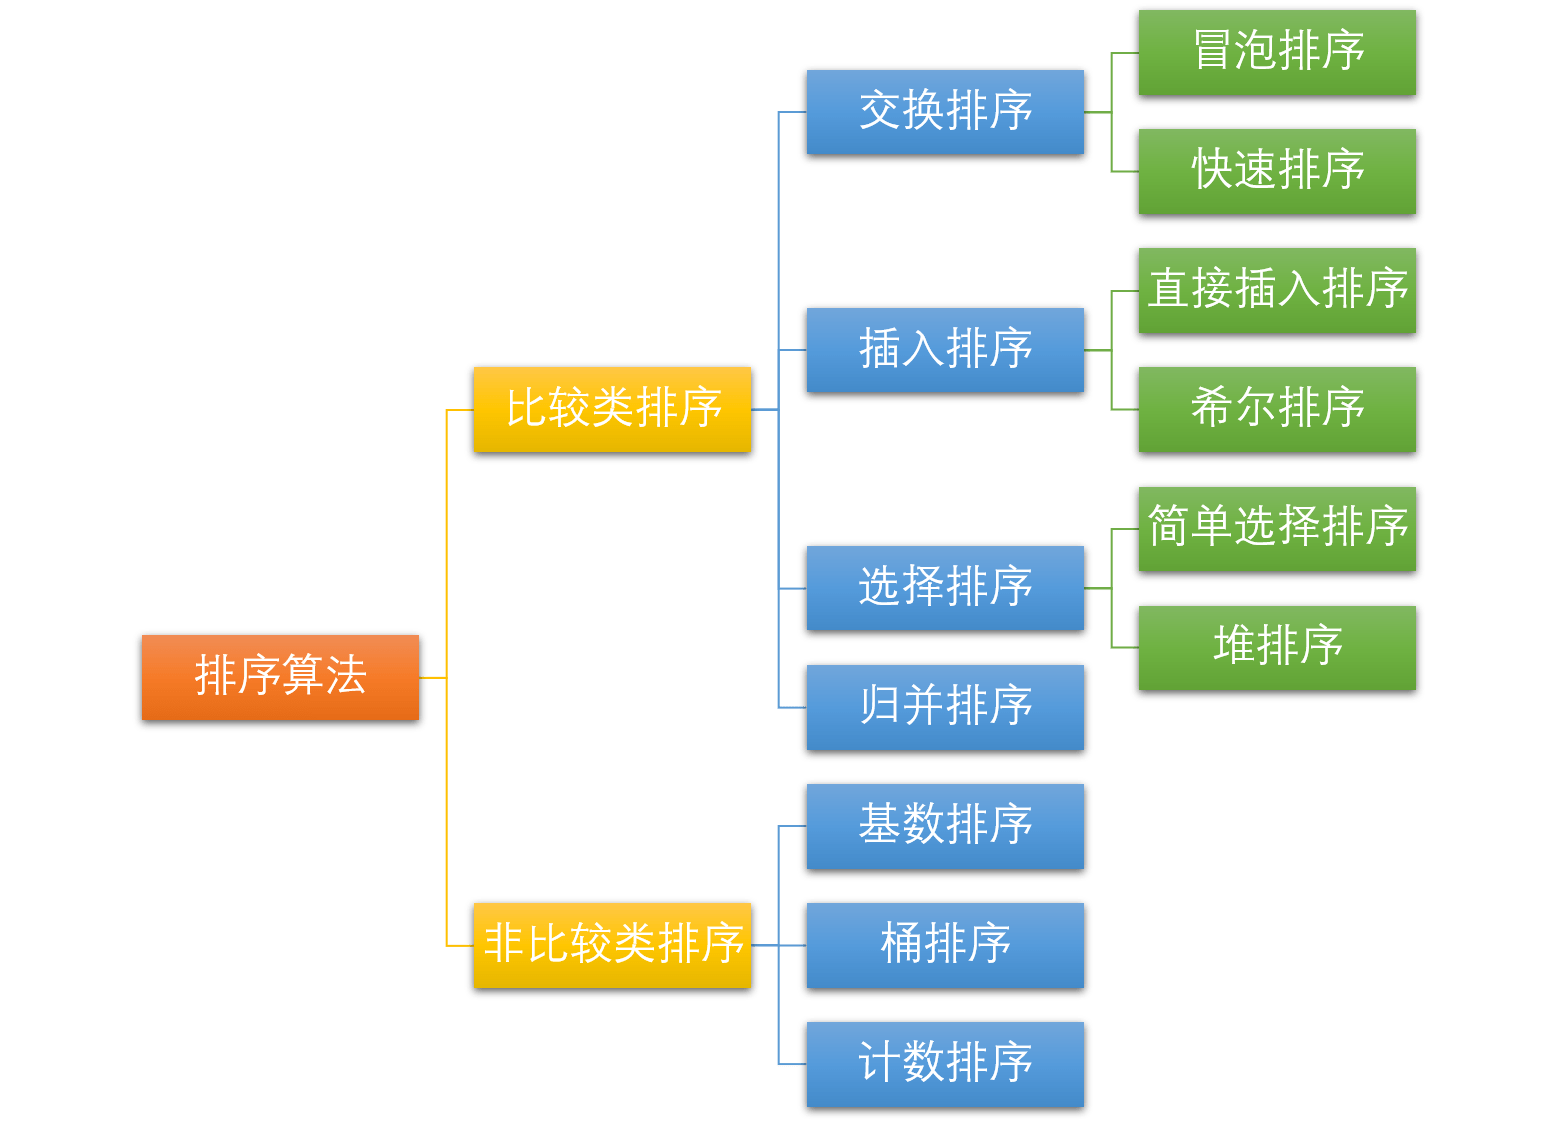
常见的快速排序、归并排序、堆排序以及冒泡排序等都属于比较类排序算法。比较类排序是通过比较来决定元素间的相对次序,由于其时间复杂度不能突破 O(nlogn),因此也称为非线性时间比较类排序。在冒泡排序之类的排序中,问题规模为 n,又因为需要比较 n 次,所以平均时间复杂度为 O(n²)。在归并排序、快速排序之类的排序中,问题规模通过分治法消减为 logn 次,所以时间复杂度平均 O(nlogn)。
比较类排序的优势是,适用于各种规模的数据,也不在乎数据的分布,都能进行排序。可以说,比较排序适用于一切需要排序的情况。
而计数排序、基数排序、桶排序则属于非比较类排序算法。非比较排序不通过比较来决定元素间的相对次序,而是通过确定每个元素之前,应该有多少个元素来排序。由于它可以突破基于比较排序的时间下界,以线性时间运行,因此称为线性时间非比较类排序。 非比较排序只要确定每个元素之前的已有的元素个数即可,所有一次遍历即可解决。算法时间复杂度O(n) 。
非比较排序时间复杂度底,但由于非比较排序需要占用空间来确定唯一位置。所以对数据规模和数据分布有一定的要求。
2.3 冒泡排序 (Bubble Sort)
冒泡排序是一种简单的排序算法。它重复地遍历要排序的序列,依次比较两个元素,如果它们的顺序错误就把它们交换过来。遍历序列的工作是重复地进行直到没有再需要交换为止,此时说明该序列已经排序完成。这个算法的名字由来是因为越小的元素会经由交换慢慢 “浮” 到数列的顶端。
2.3.1 算法步骤
- 比较相邻的元素。如果第一个比第二个大,就交换它们两个;
- 对每一对相邻元素作同样的工作,从开始第一对到结尾的最后一对,这样在最后的元素应该会是最大的数;
- 针对所有的元素重复以上的步骤,除了最后一个;
- 重复步骤 1~3,直到排序完成。
2.3.2 图解算法
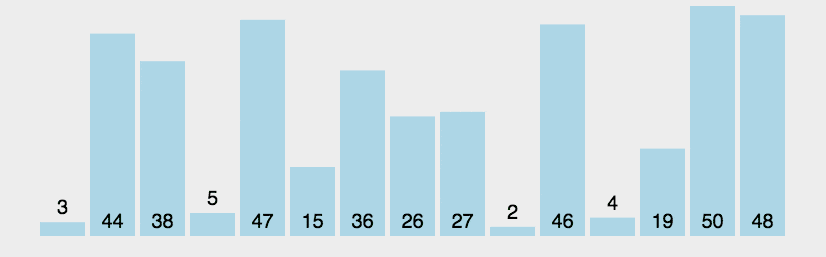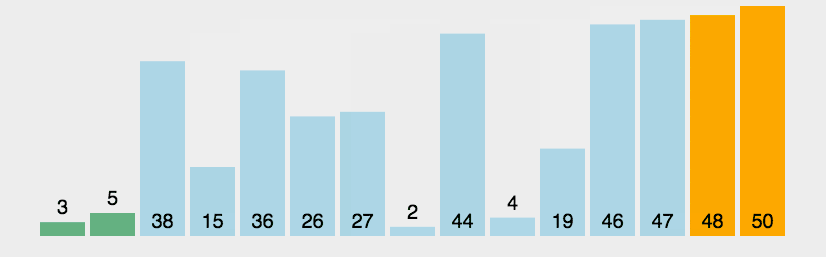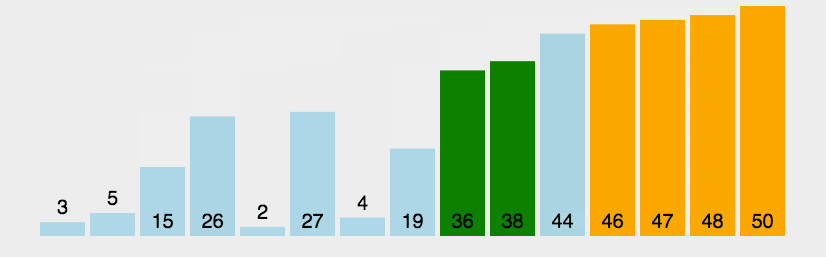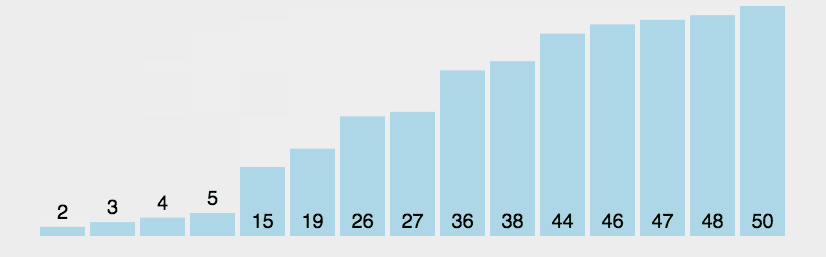
2.3.3 代码实现
/**
 * 冒泡排序
 * @param arr
 * @return arr
 */
public static int[] bubbleSort(int[] arr) {
    for (int i = 1; i < arr.length; i++) {
        // Set a flag, if true, that means the loop has not been swapped,
        // that is, the sequence has been ordered, the sorting has been completed.
        boolean flag = true;
        for (int j = 0; j < arr.length - i; j++) {
            if (arr[j] > arr[j + 1]) {
                int tmp = arr[j];
                arr[j] = arr[j + 1];
                arr[j + 1] = tmp;
       // Change flag
                flag = false;
            }
        }
        if (flag) {
            break;
        }
    }
    return arr;
}
此处对代码做了一个小优化,加入了 is_sorted Flag,目的是将算法的最佳时间复杂度优化为 O(n),即当原输入序列就是排序好的情况下,该算法的时间复杂度就是 O(n)。
2.4 选择排序 (Selection Sort)
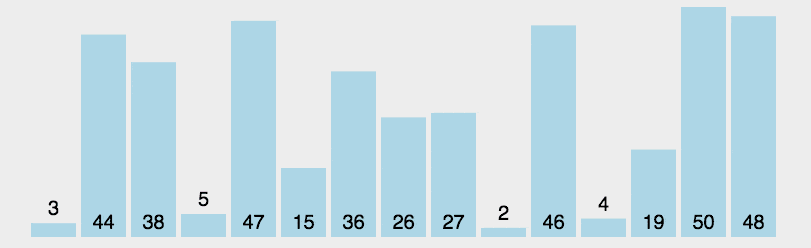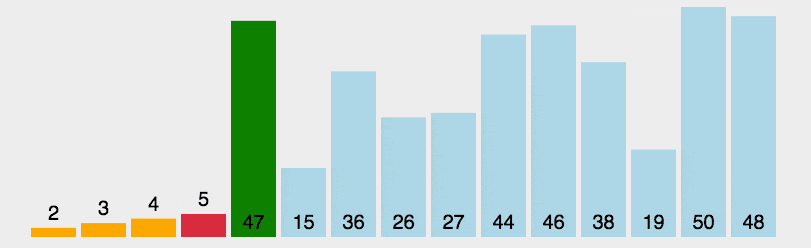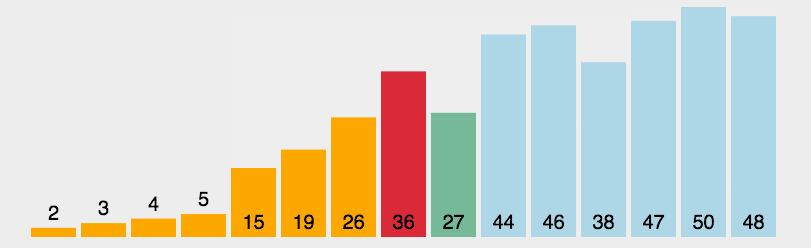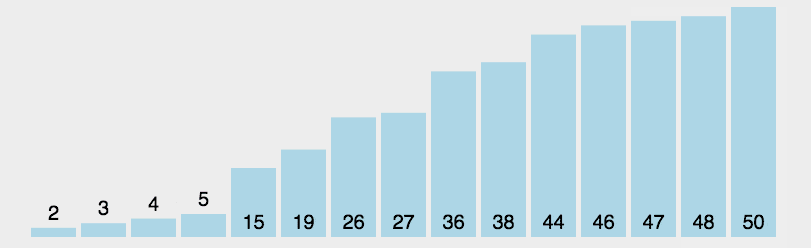
选择排序是一种简单直观的排序算法,无论什么数据进去都是 的时间复杂度。所以用到它的时候,数据规模越小越好。唯一的好处可能就是不占用额外的内存空间了吧。它的工作原理:首先在未排序序列中找到最小(大)元素,存放到排序序列的起始位置,然后,再从剩余未排序元素中继续寻找最小(大)元素,然后放到已排序序列的末尾。以此类推,直到所有元素均排序完毕。
2.4.1 算法步骤
- 首先在未排序序列中找到最小(大)元素,存放到排序序列的起始位置
- 再从剩余未排序元素中继续寻找最小(大)元素,然后放到已排序序列的末尾。
- 重复第 2 步,直到所有元素均排序完毕。
2.4.2 图解算法
2.4.3 代码实现
/**
 * 选择排序
 * @param arr
 * @return arr
 */
public static int[] selectionSort(int[] arr) {
    for (int i = 0; i < arr.length - 1; i++) {
        int minIndex = i;
        for (int j = i + 1; j < arr.length; j++) {
            if (arr[j] < arr[minIndex]) {
                minIndex = j;
            }
        }
        if (minIndex != i) {
            int tmp = arr[i];
            arr[i] = arr[minIndex];
            arr[minIndex] = tmp;
        }
    }
    return arr;
}
2.5 插入排序 (Insertion Sort)
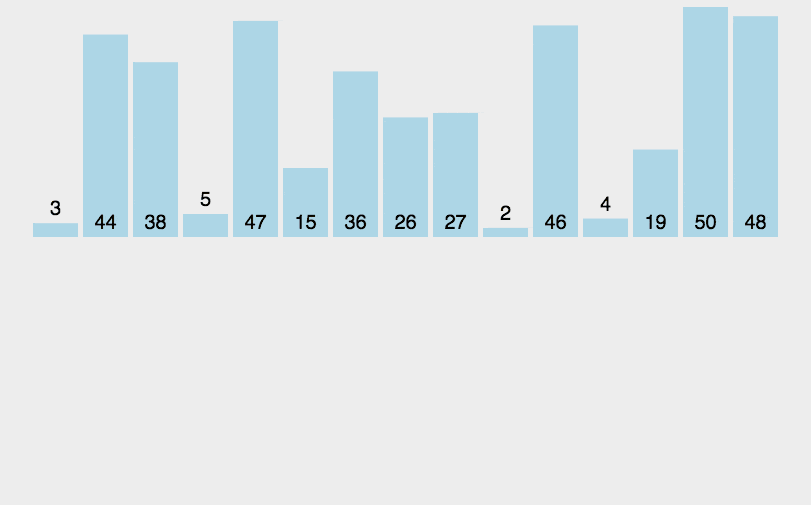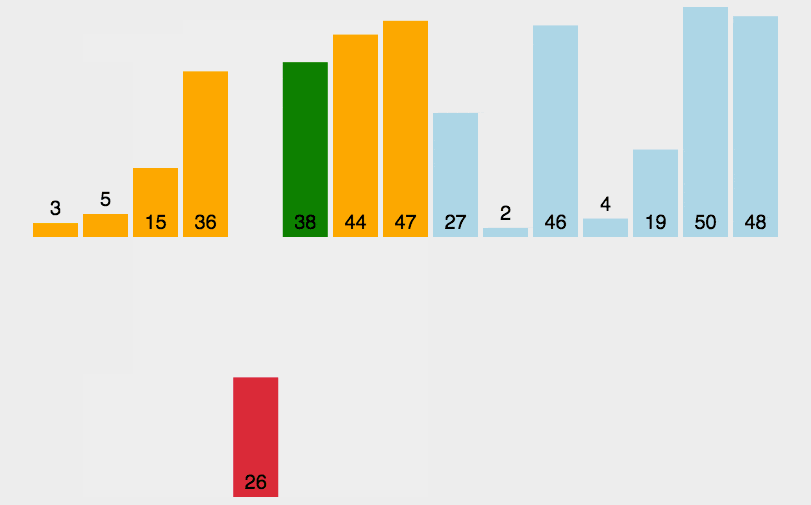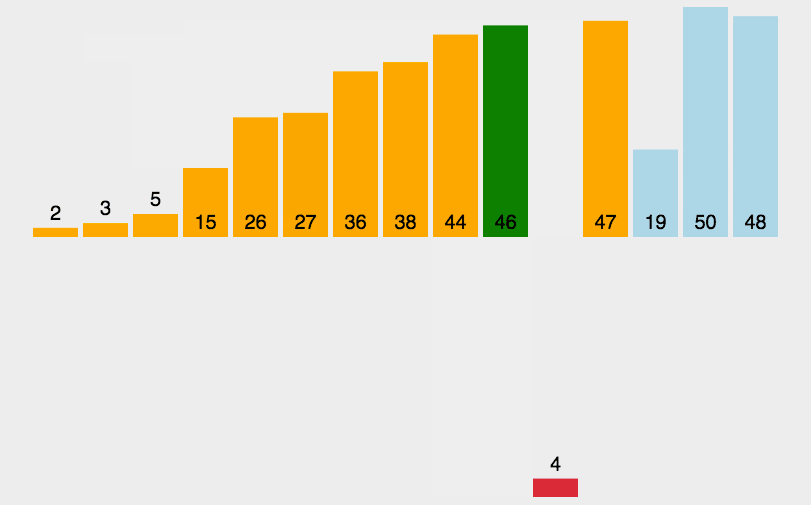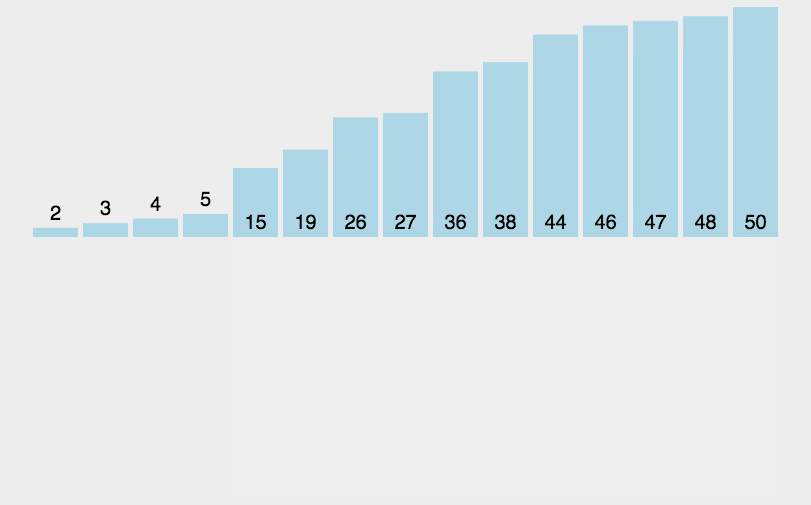
插入排序是一种简单直观的排序算法。它的工作原理是通过构建有序序列,对于未排序数据,在已排序序列中从后向前扫描,找到相应位置并插入。插入排序在实现上,通常采用 in-place 排序(即只需用到 的额外空间的排序),因而在从后向前扫描过程中,需要反复把已排序元素逐步向后挪位,为最新元素提供插入空间。
插入排序的代码实现虽然没有冒泡排序和选择排序那么简单粗暴,但它的原理应该是最容易理解的了,因为只要打过扑克牌的人都应该能够秒懂。插入排序是一种最简单直观的排序算法,它的工作原理是通过构建有序序列,对于未排序数据,在已排序序列中从后向前扫描,找到相应位置并插入。
插入排序和冒泡排序一样,也有一种优化算法,叫做拆半插入。
2.5.1 算法步骤
- 从第一个元素开始,该元素可以认为已经被排序;
- 取出下一个元素,在已经排序的元素序列中从后向前扫描;
- 如果该元素(已排序)大于新元素,将该元素移到下一位置;
- 重复步骤 3,直到找到已排序的元素小于或者等于新元素的位置;
- 将新元素插入到该位置后;
- 重复步骤 2~5。
2.5.2 图解算法
2.5.3 代码实现
/**
 * 插入排序
 * @param arr
 * @return arr
 */
public static int[] insertionSort(int[] arr) {
    for (int i = 1; i < arr.length; i++) {
        int preIndex = i - 1;
        int current = arr[i];
        while (preIndex >= 0 && current < arr[preIndex]) {
            arr[preIndex + 1] = arr[preIndex];
            preIndex -= 1;
        }
        arr[preIndex + 1] = current;
    }
    return arr;
}
2.6 希尔排序 (Shell Sort)
希尔排序是希尔 (Donald Shell) 于 1959 年提出的一种排序算法。希尔排序也是一种插入排序,它是简单插入排序经过改进之后的一个更高效的版本,也称为递减增量排序算法,同时该算法是冲破 的第一批算法之一。
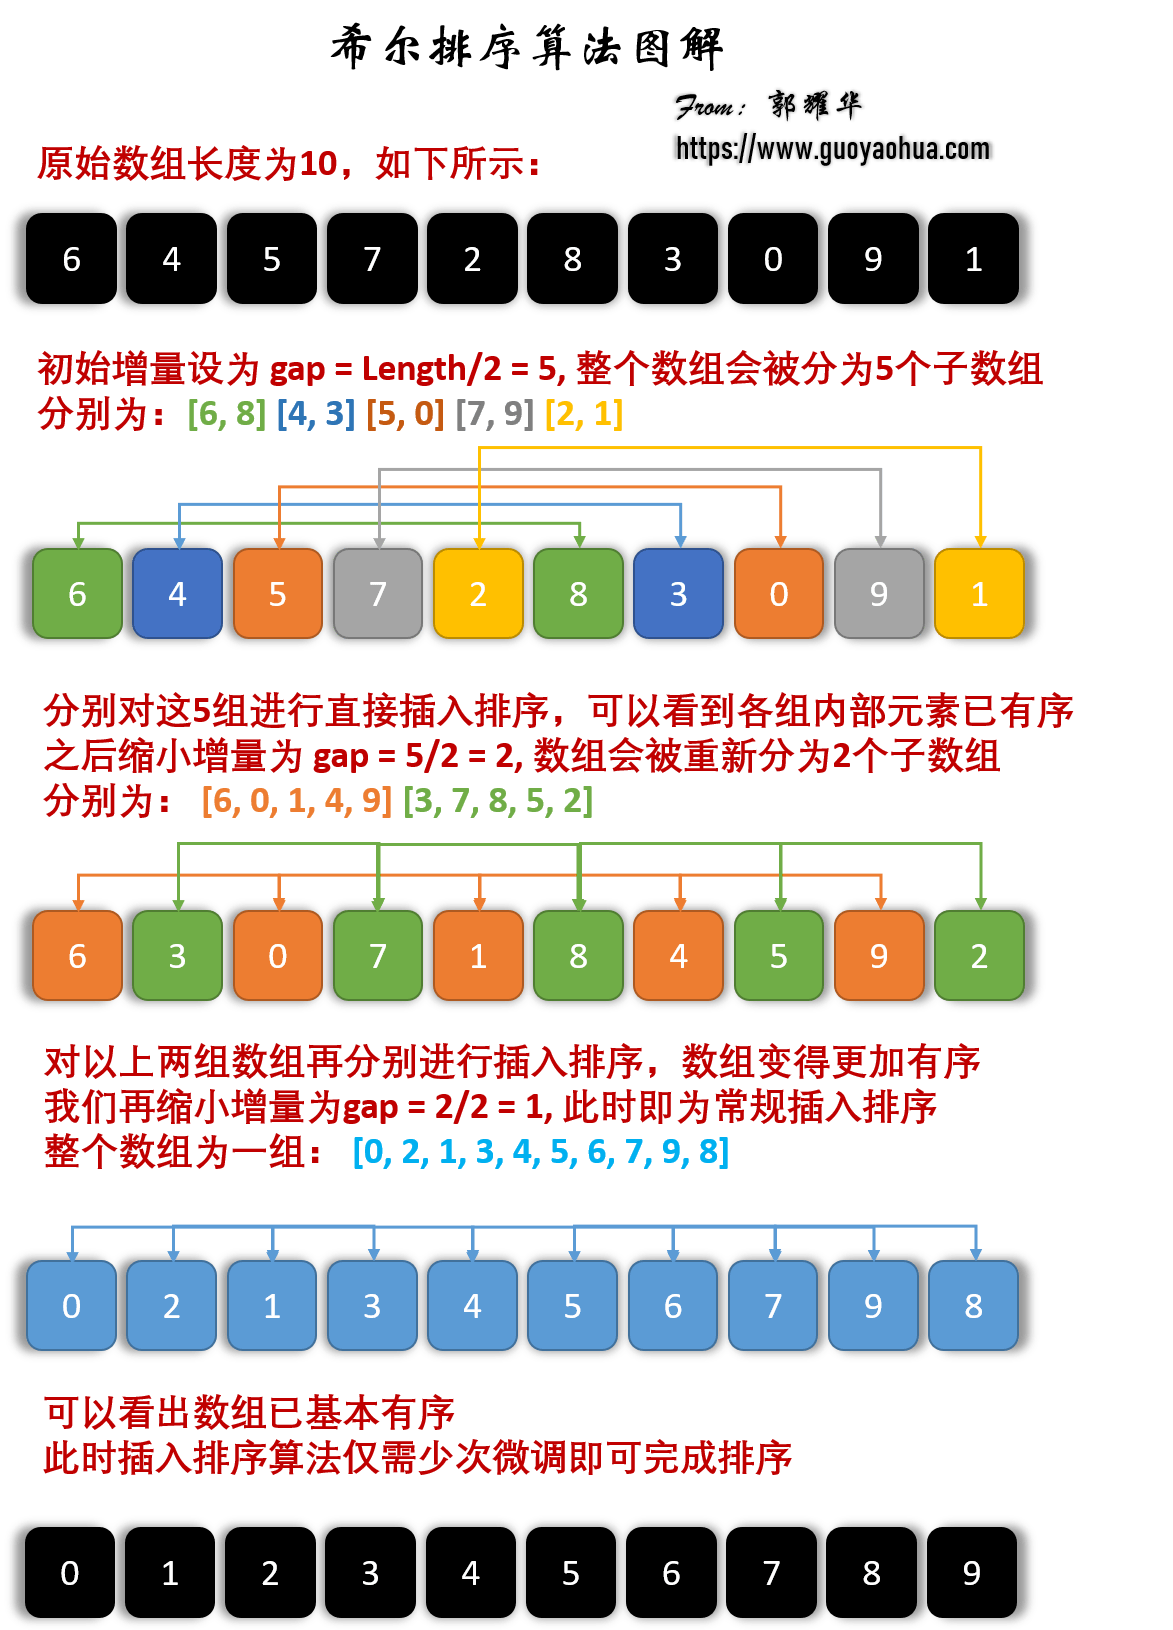
希尔排序的基本思想是:先将整个待排序的记录序列分割成为若干子序列分别进行直接插入排序,待整个序列中的记录 “基本有序” 时,再对全体记录进行依次直接插入排序。
2.6.1 算法步骤
我们来看下希尔排序的基本步骤,在此我们选择增量 ,缩小增量继续以 的方式,这种增量选择我们可以用一个序列来表示, ,称为增量序列。希尔排序的增量序列的选择与证明是个数学难题,我们选择的这个增量序列是比较常用的,也是希尔建议的增量,称为希尔增量,但其实这个增量序列不是最优的。此处我们做示例使用希尔增量。
先将整个待排序的记录序列分割成为若干子序列分别进行直接插入排序,具体算法描述:
- 选择一个增量序列 ,其中 ;
- 按增量序列个数 k,对序列进行 k 趟排序;
- 每趟排序,根据对应的增量 t,将待排序列分割成若干长度为 m 的子序列,分别对各子表进行直接插入排序。仅增量因子为 1 时,整个序列作为一个表来处理,表长度即为整个序列的长度。
2.6.2 图解算法
2.6.3 代码实现
/**
 * 希尔排序
 *
 * @param arr
 * @return arr
 */
public static int[] shellSort(int[] arr) {
    int n = arr.length;
    int gap = n / 2;
    while (gap > 0) {
        for (int i = gap; i < n; i++) {
            int current = arr[i];
            int preIndex = i - gap;
            // Insertion sort
            while (preIndex >= 0 && arr[preIndex] > current) {
                arr[preIndex + gap] = arr[preIndex];
                preIndex -= gap;
            }
            arr[preIndex + gap] = current;

        }
        gap /= 2;
    }
    return arr;
}
2.7 归并排序 (Merge Sort)
归并排序是建立在归并操作上的一种有效的排序算法。该算法是采用分治法 (Divide and Conquer) 的一个非常典型的应用。归并排序是一种稳定的排序方法。将已有序的子序列合并,得到完全有序的序列;即先使每个子序列有序,再使子序列段间有序。若将两个有序表合并成一个有序表,称为 2 - 路归并。
和选择排序一样,归并排序的性能不受输入数据的影响,但表现比选择排序好的多,因为始终都是 的时间复杂度。代价是需要额外的内存空间。
2.7.1 算法步骤
归并排序算法是一个递归过程,边界条件为当输入序列仅有一个元素时,直接返回,具体过程如下:
- 如果输入内只有一个元素,则直接返回,否则将长度为 n 的输入序列分成两个长度为 n/2 的子序列;
- 分别对这两个子序列进行归并排序,使子序列变为有序状态;
- 设定两个指针,分别指向两个已经排序子序列的起始位置;
- 比较两个指针所指向的元素,选择相对小的元素放入到合并空间(用于存放排序结果),并移动指针到下一位置;
- 重复步骤 3 ~ 4 直到某一指针达到序列尾;
- 将另一序列剩下的所有元素直接复制到合并序列尾。
2.7.2 图解算法
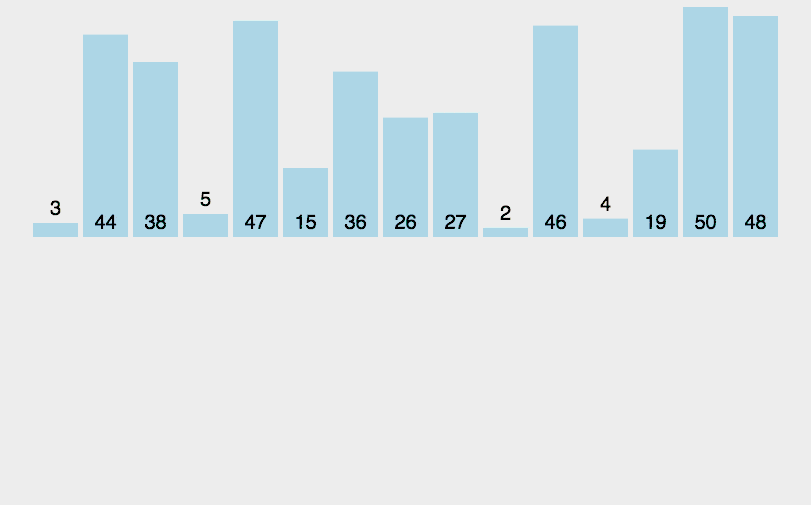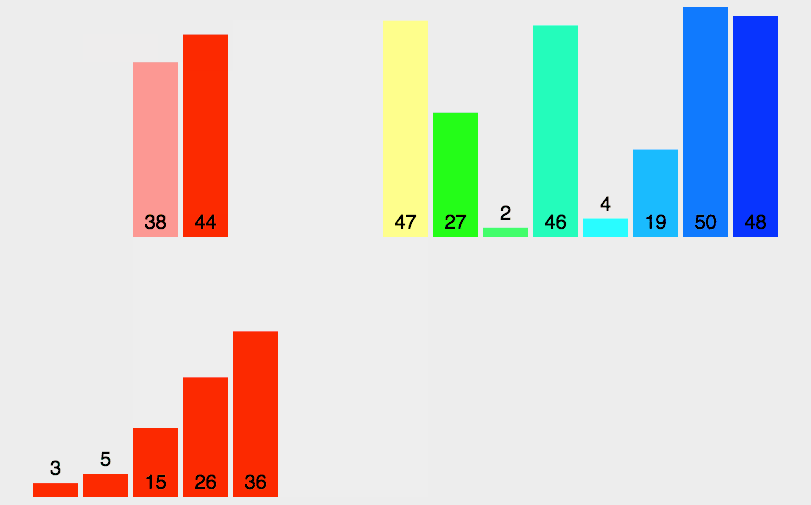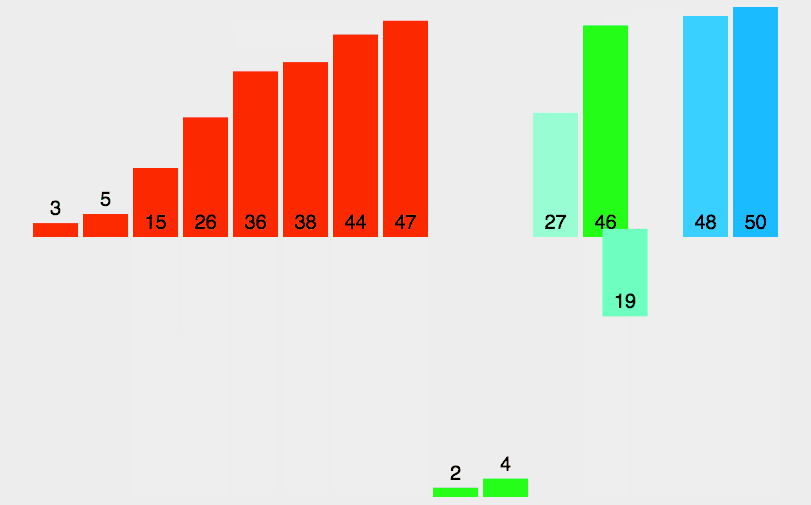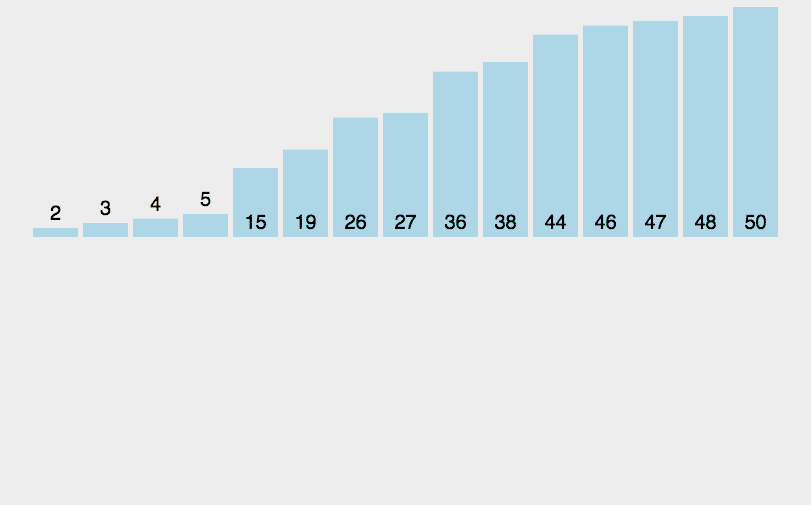
2.7.3 代码实现
/**
 * 归并排序
 *
 * @param arr
 * @return arr
 */
public static int[] mergeSort(int[] arr) {
    if (arr.length <= 1) {
        return arr;
    }
    int middle = arr.length / 2;
    int[] arr_1 = Arrays.copyOfRange(arr, 0, middle);
    int[] arr_2 = Arrays.copyOfRange(arr, middle, arr.length);
    return merge(mergeSort(arr_1), mergeSort(arr_2));
}

/**
 * Merge two sorted arrays
 *
 * @param arr_1
 * @param arr_2
 * @return sorted_arr
 */
public static int[] merge(int[] arr_1, int[] arr_2) {
    int[] sorted_arr = new int[arr_1.length + arr_2.length];
    int idx = 0, idx_1 = 0, idx_2 = 0;
    while (idx_1 < arr_1.length && idx_2 < arr_2.length) {
        if (arr_1[idx_1] < arr_2[idx_2]) {
            sorted_arr[idx] = arr_1[idx_1];
            idx_1 += 1;
        } else {
            sorted_arr[idx] = arr_2[idx_2];
            idx_2 += 1;
        }
        idx += 1;
    }
    if (idx_1 < arr_1.length) {
        while (idx_1 < arr_1.length) {
            sorted_arr[idx] = arr_1[idx_1];
            idx_1 += 1;
            idx += 1;
        }
    } else {
        while (idx_2 < arr_2.length) {
            sorted_arr[idx] = arr_2[idx_2];
            idx_2 += 1;
            idx += 1;
        }
    }
    return sorted_arr;
}
2.8 *快速排序 (Quick Sort)
快速排序用到了分治思想,同样的还有归并排序。乍看起来快速排序和归并排序非常相似,都是将问题变小,先排序子串,最后合并。不同的是快速排序在划分子问题的时候经过多一步处理,将划分的两组数据划分为一大一小,这样在最后合并的时候就不必像归并排序那样再进行比较。但也正因为如此,划分的不定性使得快速排序的时间复杂度并不稳定。
快速排序的基本思想:通过一趟排序将待排序列分隔成独立的两部分,其中一部分记录的元素均比另一部分的元素小,则可分别对这两部分子序列继续进行排序,以达到整个序列有序。
2.8.1 算法步骤
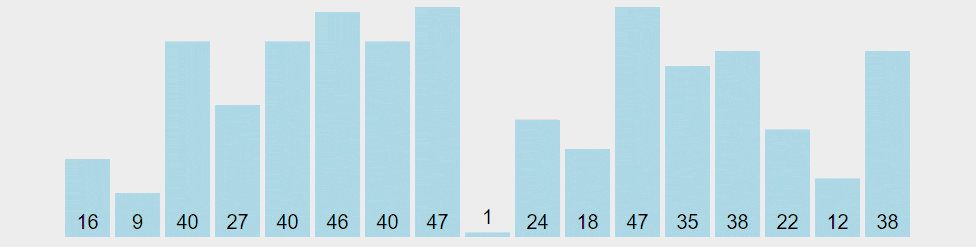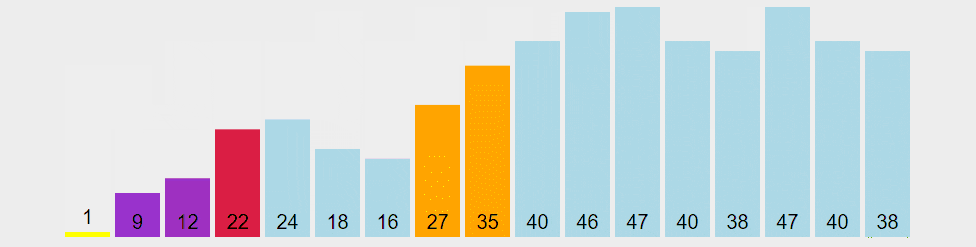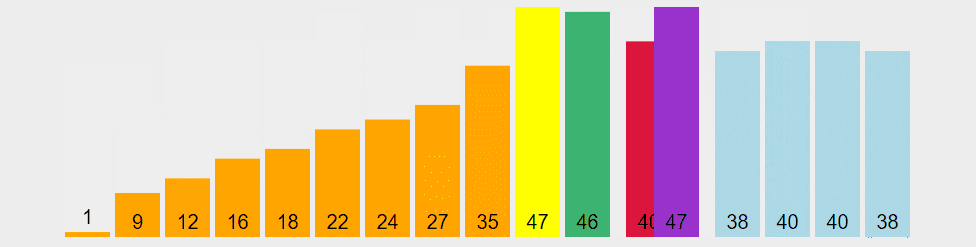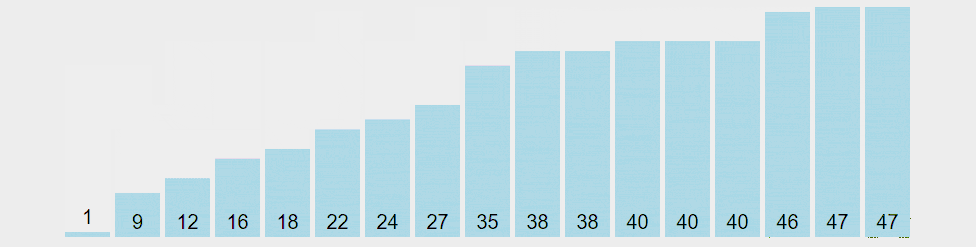
快速排序使用分治法 open in new window(Divide and conquer)策略来把一个序列分为较小和较大的 2 个子序列,然后递归地排序两个子序列。具体算法描述如下:
- 从序列中随机挑出一个元素,做为 “基准”(
pivot); - 重新排列序列,将所有比基准值小的元素摆放在基准前面,所有比基准值大的摆在基准的后面(相同的数可以到任一边)。在这个操作结束之后,该基准就处于数列的中间位置。这个称为分区(partition)操作;
- 递归地把小于基准值元素的子序列和大于基准值元素的子序列进行快速排序。
2.8.2 图解算法
2.8.3 代码实现
public static int partition(int[] array, int low, int high) {
    int pivot = array[high];
    int pointer = low;
    for (int i = low; i < high; i++) {
        if (array[i] <= pivot) {
            int temp = array[i];
            array[i] = array[pointer];
            array[pointer] = temp;
            pointer++;
        }
        System.out.println(Arrays.toString(array));
    }
    int temp = array[pointer];
    array[pointer] = array[high];
    array[high] = temp;
    return pointer;
}
public static void quickSort(int[] array, int low, int high) {
    if (low < high) {
        int position = partition(array, low, high);
        quickSort(array, low, position - 1);
        quickSort(array, position + 1, high);
    }
}
2.9 堆排序 (Heap Sort)
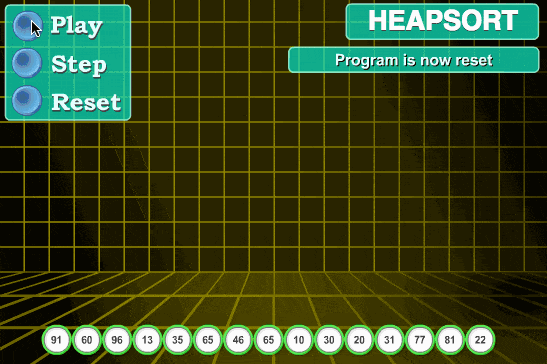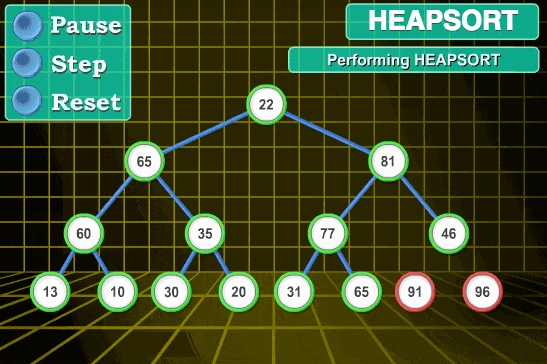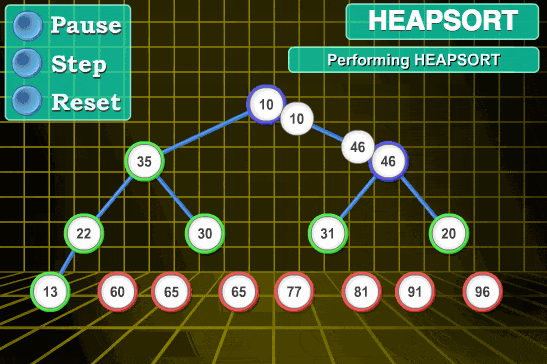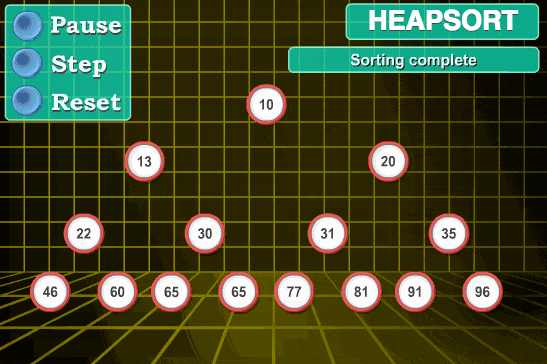
堆排序是指利用堆这种数据结构所设计的一种排序算法。堆是一个近似完全二叉树的结构,并同时满足堆的性质:即子结点的值总是小于(或者大于)它的父节点。
2.9.1 算法步骤
- 将初始待排序列 构建成大顶堆,此堆为初始的无序区;
- 将堆顶元素 与最后一个元素 交换,此时得到新的无序区 和新的有序区 , 且满足 ;
- 由于交换后新的堆顶 可能违反堆的性质,因此需要对当前无序区 调整为新堆,然后再次将 与无序区最后一个元素交换,得到新的无序区 和新的有序区 。不断重复此过程直到有序区的元素个数为 n-1,则整个排序过程完成。
2.9.2 图解算法
2.9.3 代码实现
// Global variable that records the length of an array;
static int heapLen;

/**
 * Swap the two elements of an array
 * @param arr
 * @param i
 * @param j
 */
private static void swap(int[] arr, int i, int j) {
    int tmp = arr[i];
    arr[i] = arr[j];
    arr[j] = tmp;
}

/**
 * Build Max Heap
 * @param arr
 */
private static void buildMaxHeap(int[] arr) {
    for (int i = arr.length / 2 - 1; i >= 0; i--) {
        heapify(arr, i);
    }
}

/**
 * Adjust it to the maximum heap
 * @param arr
 * @param i
 */
private static void heapify(int[] arr, int i) {
    int left = 2 * i + 1;
    int right = 2 * i + 2;
    int largest = i;
    if (right < heapLen && arr[right] > arr[largest]) {
        largest = right;
    }
    if (left < heapLen && arr[left] > arr[largest]) {
        largest = left;
    }
    if (largest != i) {
        swap(arr, largest, i);
        heapify(arr, largest);
    }
}

/**
 * Heap Sort
 * @param arr
 * @return
 */
public static int[] heapSort(int[] arr) {
    // index at the end of the heap
    heapLen = arr.length;
    // build MaxHeap
    buildMaxHeap(arr);
    for (int i = arr.length - 1; i > 0; i--) {
        // Move the top of the heap to the tail of the heap in turn
        swap(arr, 0, i);
        heapLen -= 1;
        heapify(arr, 0);
    }
    return arr;
}
2.10 计数排序 (Counting Sort)
计数排序的核心在于将输入的数据值转化为键存储在额外开辟的数组空间中。 作为一种线性时间复杂度的排序,计数排序要求输入的数据必须是有确定范围的整数。
计数排序 (Counting sort) 是一种稳定的排序算法。计数排序使用一个额外的数组 C,其中第 i 个元素是待排序数组 A 中值等于 i 的元素的个数。然后根据数组 C 来将 A 中的元素排到正确的位置。它只能对整数进行排序。
2.10.1 算法步骤
- 找出数组中的最大值
max、最小值min; - 创建一个新数组
C,其长度是max-min+1,其元素默认值都为 0; - 遍历原数组
A中的元素A[i],以A[i] - min作为C数组的索引,以A[i]的值在A中元素出现次数作为C[A[i] - min]的值; - 对
C数组变形,新元素的值是该元素与前一个元素值的和,即当i>1时C[i] = C[i] + C[i-1]; - 创建结果数组
R,长度和原始数组一样。 - 从后向前遍历原始数组
A中的元素A[i],使用A[i]减去最小值min作为索引,在计数数组C中找到对应的值C[A[i] - min],C[A[i] - min] - 1就是A[i]在结果数组R中的位置,做完上述这些操作,将count[A[i] - min]减小 1。
2.10.2 图解算法
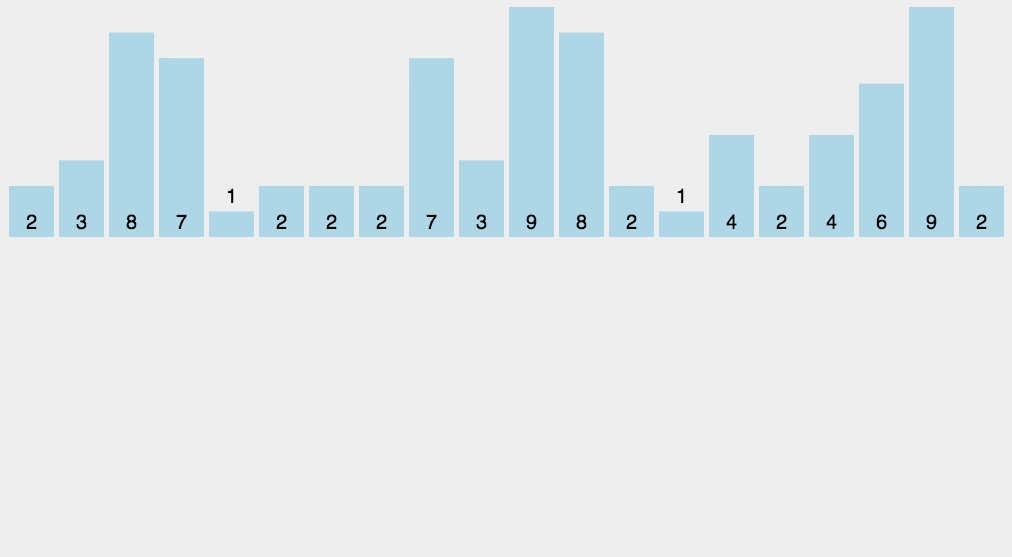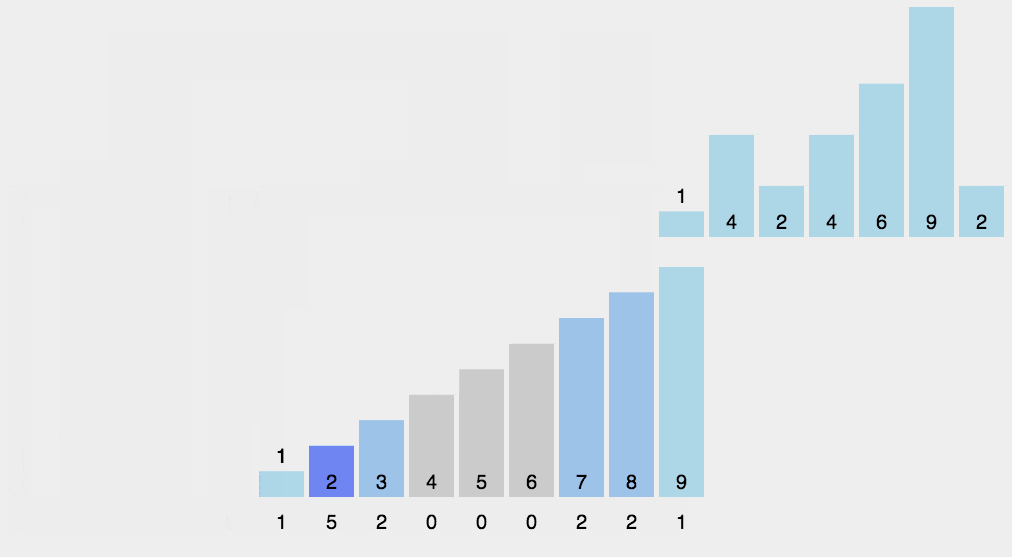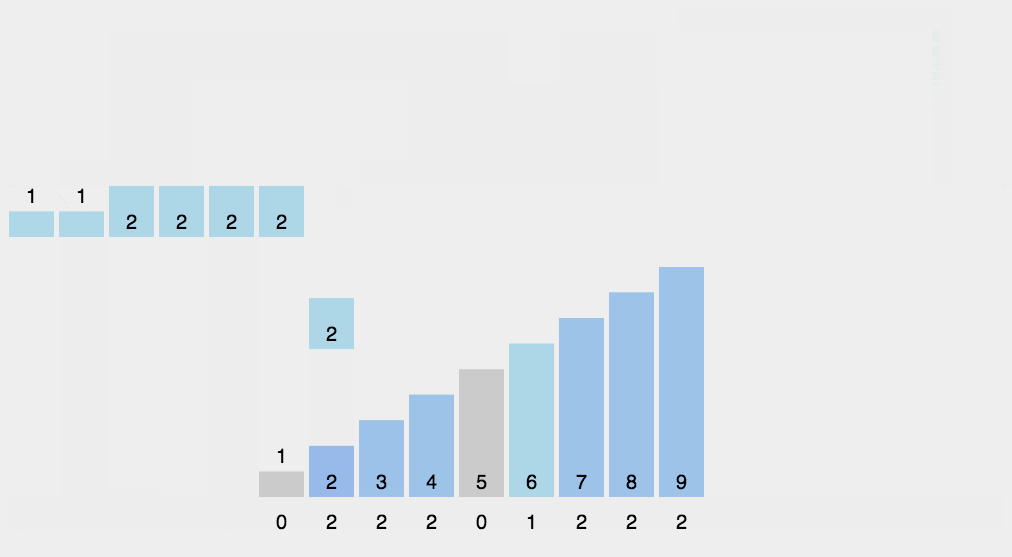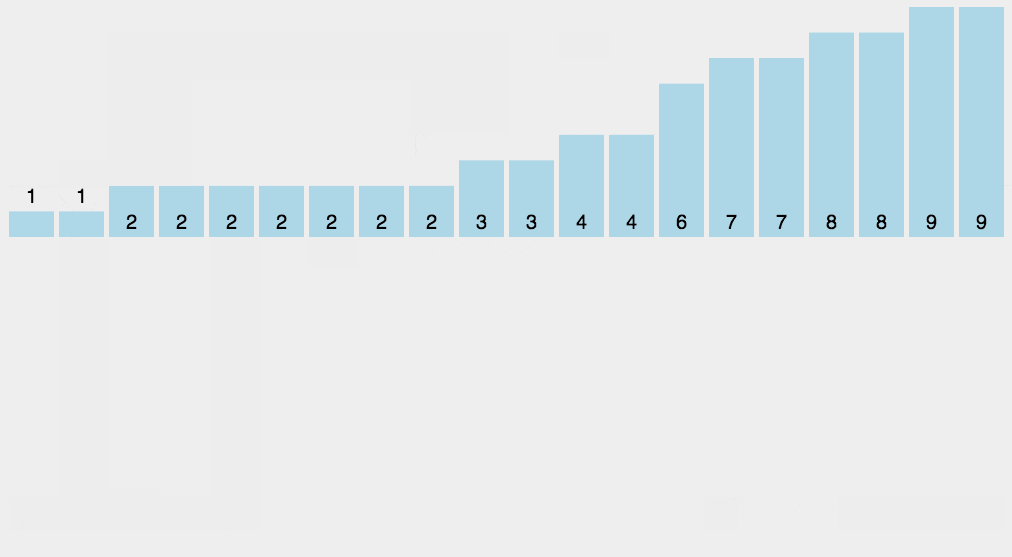
2.10.3 代码实现
/**
 * Gets the maximum and minimum values in the array
 *
 * @param arr
 * @return
 */
private static int[] getMinAndMax(int[] arr) {
    int maxValue = arr[0];
    int minValue = arr[0];
    for (int i = 0; i < arr.length; i++) {
        if (arr[i] > maxValue) {
            maxValue = arr[i];
        } else if (arr[i] < minValue) {
            minValue = arr[i];
        }
    }
    return new int[] { minValue, maxValue };
}

/**
 * Counting Sort
 *
 * @param arr
 * @return
 */
public static int[] countingSort(int[] arr) {
    if (arr.length < 2) {
        return arr;
    }
    int[] extremum = getMinAndMax(arr);
    int minValue = extremum[0];
    int maxValue = extremum[1];
    int[] countArr = new int[maxValue - minValue + 1];
    int[] result = new int[arr.length];

    for (int i = 0; i < arr.length; i++) {
        countArr[arr[i] - minValue] += 1;
    }
    for (int i = 1; i < countArr.length; i++) {
        countArr[i] += countArr[i - 1];
    }
    for (int i = arr.length - 1; i >= 0; i--) {
        int idx = countArr[arr[i] - minValue] - 1;
        result[idx] = arr[i];
        countArr[arr[i] - minValue] -= 1;
    }
    return result;
}
2.11 桶排序 (Bucket Sort)
桶排序是计数排序的升级版。它利用了函数的映射关系,高效与否的关键就在于这个映射函数的确定。为了使桶排序更加高效,我们需要做到这两点:
- 在额外空间充足的情况下,尽量增大桶的数量
- 使用的映射函数能够将输入的 N 个数据均匀的分配到 K 个桶中
桶排序的工作的原理:假设输入数据服从均匀分布,将数据分到有限数量的桶里,每个桶再分别排序(有可能再使用别的排序算法或是以递归方式继续使用桶排序进行。
2.11.1 算法步骤
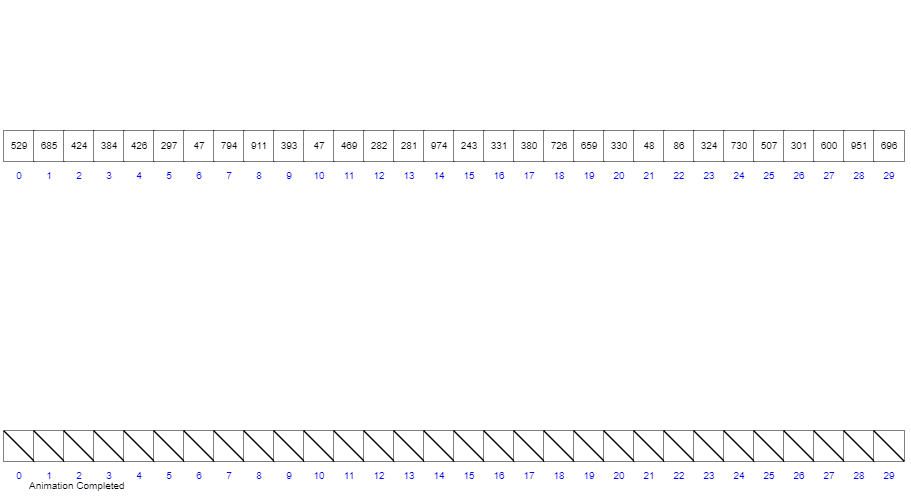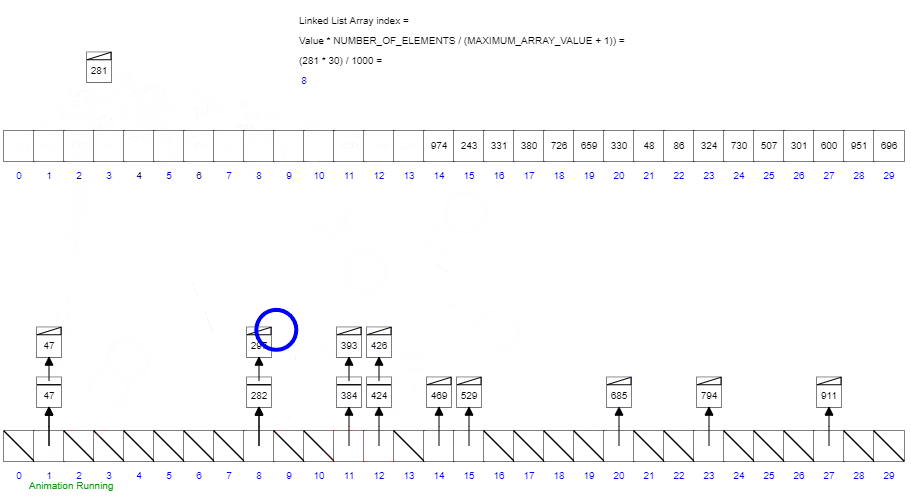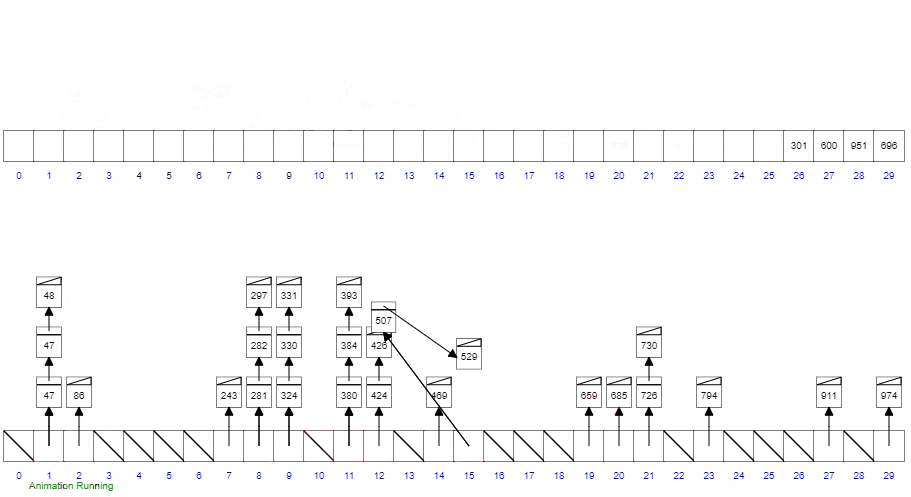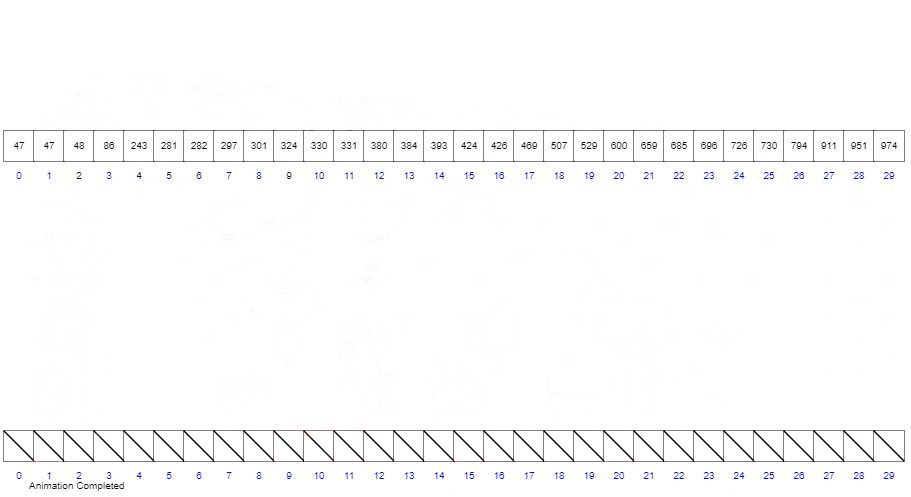
- 设置一个 BucketSize,作为每个桶所能放置多少个不同数值;
- 遍历输入数据,并且把数据依次映射到对应的桶里去;
- 对每个非空的桶进行排序,可以使用其它排序方法,也可以递归使用桶排序;
- 从非空桶里把排好序的数据拼接起来。
2.11.2 图解算法
2.11.3 代码实现
/**
 * Gets the maximum and minimum values in the array
 * @param arr
 * @return
 */
private static int[] getMinAndMax(List<Integer> arr) {
    int maxValue = arr.get(0);
    int minValue = arr.get(0);
    for (int i : arr) {
        if (i > maxValue) {
            maxValue = i;
        } else if (i < minValue) {
            minValue = i;
        }
    }
    return new int[] { minValue, maxValue };
}

/**
 * Bucket Sort
 * @param arr
 * @return
 */
public static List<Integer> bucketSort(List<Integer> arr, int bucket_size) {
    if (arr.size() < 2 || bucket_size == 0) {
        return arr;
    }
    int[] extremum = getMinAndMax(arr);
    int minValue = extremum[0];
    int maxValue = extremum[1];
    int bucket_cnt = (maxValue - minValue) / bucket_size + 1;
    List<List<Integer>> buckets = new ArrayList<>();
    for (int i = 0; i < bucket_cnt; i++) {
        buckets.add(new ArrayList<Integer>());
    }
    for (int element : arr) {
        int idx = (element - minValue) / bucket_size;
        buckets.get(idx).add(element);
    }
    for (int i = 0; i < buckets.size(); i++) {
        if (buckets.get(i).size() > 1) {
            buckets.set(i, sort(buckets.get(i), bucket_size / 2));
        }
    }
    ArrayList<Integer> result = new ArrayList<>();
    for (List<Integer> bucket : buckets) {
        for (int element : bucket) {
            result.add(element);
        }
    }
    return result;
}
2.12 基数排序 (Radix Sort)
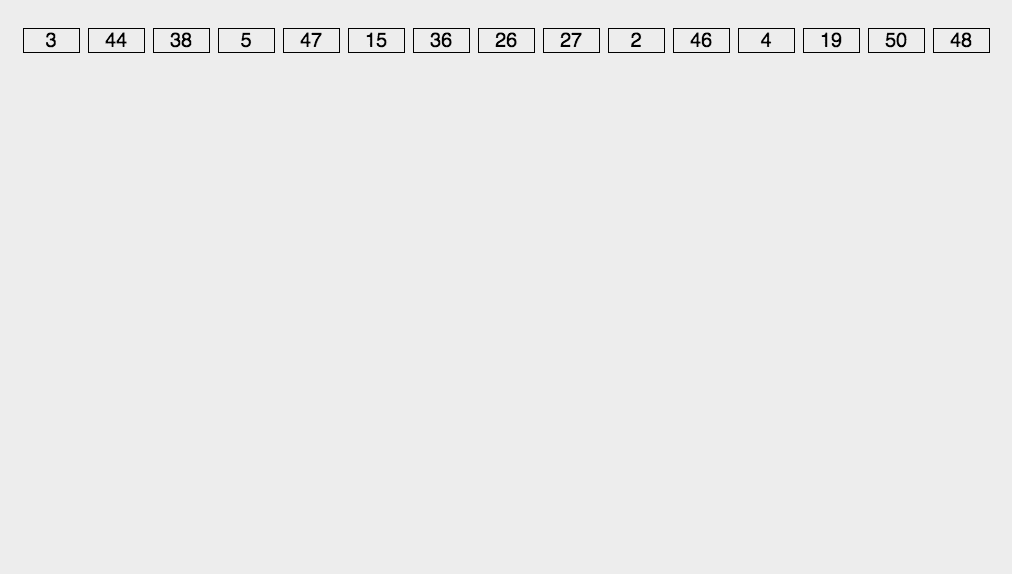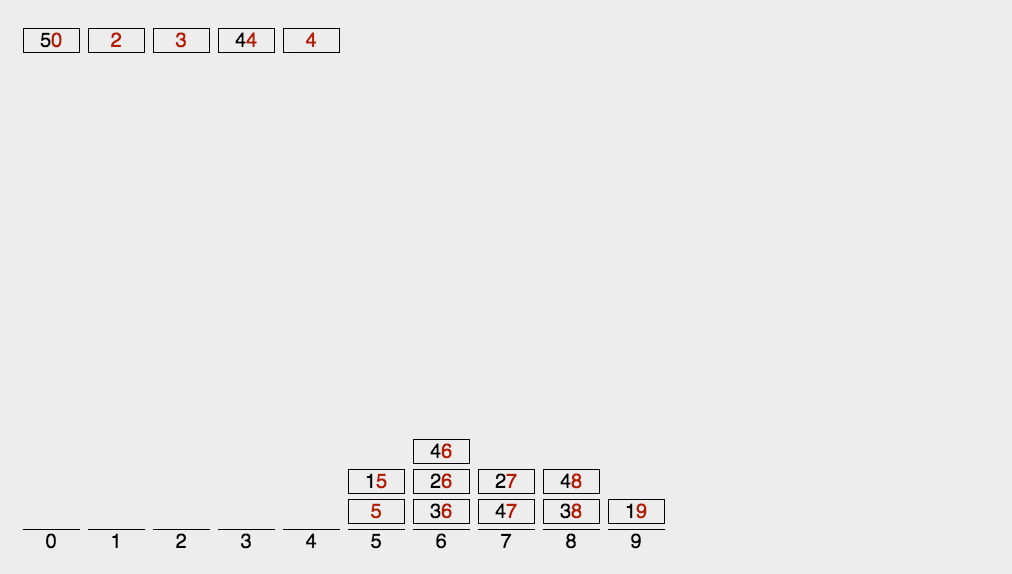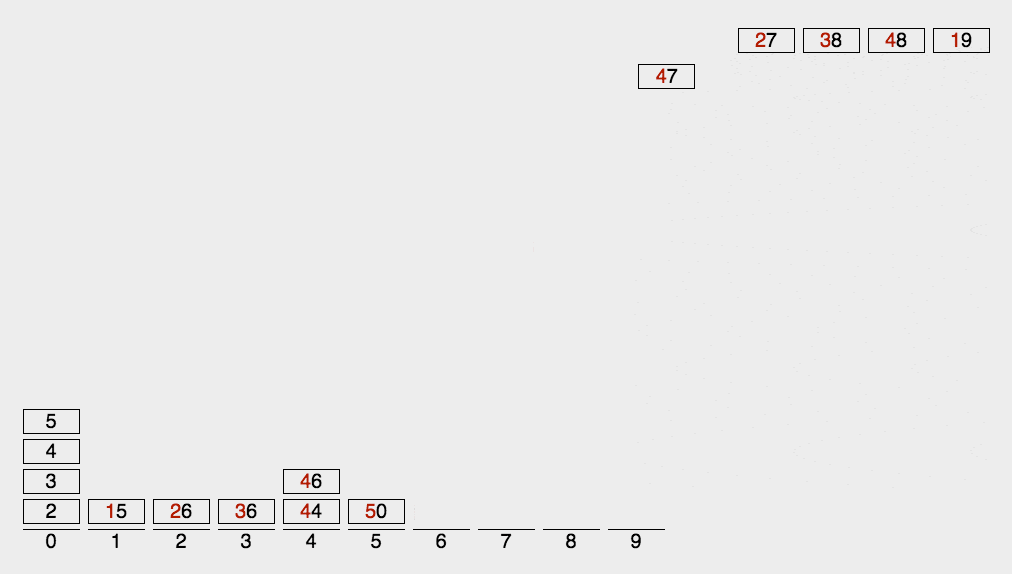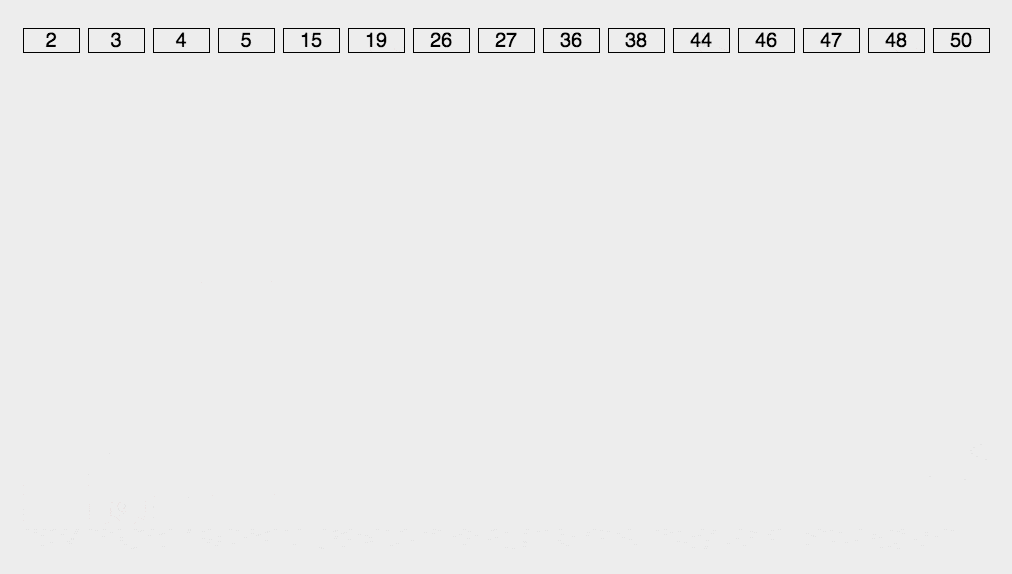
基数排序也是非比较的排序算法,对元素中的每一位数字进行排序,从最低位开始排序,复杂度为 ,n 为数组长度,k 为数组中元素的最大的位数;
基数排序是按照低位先排序,然后收集;再按照高位排序,然后再收集;依次类推,直到最高位。有时候有些属性是有优先级顺序的,先按低优先级排序,再按高优先级排序。最后的次序就是高优先级高的在前,高优先级相同的低优先级高的在前。基数排序基于分别排序,分别收集,所以是稳定的。
2.12.1 算法步骤
- 取得数组中的最大数,并取得位数,即为迭代次数 N(例如:数组中最大数值为 1000,则 N=4);
A为原始数组,从最低位开始取每个位组成radix数组;- 对
radix进行计数排序(利用计数排序适用于小范围数的特点); - 将
radix依次赋值给原数组; - 重复 2~4 步骤 N 次
2.12.2 图解算法
2.12.3 代码实现
/**
 * Radix Sort
 *
 * @param arr
 * @return
 */
public static int[] radixSort(int[] arr) {
    if (arr.length < 2) {
        return arr;
    }
    int N = 1;
    int maxValue = arr[0];
    for (int element : arr) {
        if (element > maxValue) {
            maxValue = element;
        }
    }
    while (maxValue / 10 != 0) {
        maxValue = maxValue / 10;
        N += 1;
    }
    for (int i = 0; i < N; i++) {
        List<List<Integer>> radix = new ArrayList<>();
        for (int k = 0; k < 10; k++) {
            radix.add(new ArrayList<Integer>());
        }
        for (int element : arr) {
            int idx = (element / (int) Math.pow(10, i)) % 10;
            radix.get(idx).add(element);
        }
        int idx = 0;
        for (List<Integer> l : radix) {
            for (int n : l) {
                arr[idx++] = n;
            }
        }
    }
    return arr;
}
基数排序 vs 计数排序 vs 桶排序
这三种排序算法都利用了桶的概念,但对桶的使用方法上有明显差异:
- 基数排序:根据键值的每位数字来分配桶
- 计数排序:每个桶只存储单一键值
- 桶排序:每个桶存储一定范围的数值
参考链接: