无人机辅助移动边缘计算的计算卸载优化:一种深度确定性策略梯度方法(3)——基础知识
参考文献:
[1] Wang Y , Fang W , Ding Y , et al. Computation offloading optimization for UAV-assisted mobile edge computing: a deep deterministic policy gradient approach[J]. Wireless Networks, 2021:1-16.doi:https://doi.org/10.1007/s11276-021-02632-z
3 基于DDPG的计算卸载优化
在本节中,我们首先介绍MDP、Q-Learning、DQN和DDPG这些重要的新兴RL技术的基本知识。然后,讨论了如何利用DDPG来训练无人机辅助MEC系统的高效计算卸载策略。详细地定义了状态空间、动作空间和奖励函数,描述了数据预处理的状态归一化,并举例说明了训练算法和测试算法的过程。
3.1 RL介绍
3.1.1 MDP
MDP是描述离散时间随机控制过程的数学框架 ,在该过程中,结果是部分随机的,并且处于主体或决策者的控制下。它正式地描述了一个环境,它是完全可观察到的强化学习 。通常,MDP可以定义为一个元组 ( S , A , p ( . , . ) , r ) (\mathcal{S}, \mathcal{A}, p(.,.), r) ( S , A , p ( . , . ) , r ) p ( s i + 1 ∣ s i , a i ) p(s_{i+1}|s_i,a_i) p ( s i + 1 ∣ s i , a i ) a i ∈ A a_i \in \mathcal{A} a i ∈ A s i ∈ S s_i \in \mathcal S s i ∈ S s i + 1 ∈ S s_{i+1} \in \mathcal S s i + 1 ∈ S
R i = ∑ l = i ∞ γ l − i r l R_{i}=\sum_{l=i}^{\infty} \gamma^{l-i} r_{l}
R i = l = i ∑ ∞ γ l − i r l
其中, γ ∈ [ 0 , 1 ] \gamma \in [0, 1] γ ∈ [ 0 , 1 ] r l = r ( s l , a l ) r_{l}=r(s_l,a_l) r l = r ( s l , a l ) l l l π \pi π s i s_i s i
V π ( s i ) = E π [ R i ∣ s i ] V_{\pi}\left(s_{i}\right)=\mathbb{E}_{\pi}\left[R_{i} \mid s_{i}\right]
V π ( s i ) = E π [ R i ∣ s i ]
同样,在策略 π \pi π s i s_i s i a i a_i a i
Q π ( s i ) = E π [ R i ∣ s i , a i ] Q_{\pi}\left(s_{i}\right)=\mathbb{E}_{\pi}\left[R_{i} \mid s_{i}, a_{i}\right]
Q π ( s i ) = E π [ R i ∣ s i , a i ]
根据Bellman方程,状态值函数和动作值函数的递归关系分别表示为:
V π ( s i ) = E π [ r ( s i , a i ) + γ V π ( s i + 1 ) ] Q π ( s i , a i ) = E π [ r ( s i , a i ) + γ Q π ( s i + 1 , a i + 1 ) ] \begin{array}{l} V_{\pi}\left(s_{i}\right)=\mathbb{E}_{\pi}\left[r\left(s_{i}, a_{i}\right)+\gamma V_{\pi}\left(s_{i+1}\right)\right] \\ Q_{\pi}\left(s_{i}, a_{i}\right)=\mathbb{E}_{\pi}\left[r\left(s_{i}, a_{i}\right)+\gamma Q_{\pi}\left(s_{i+1}, a_{i+1}\right)\right] \end{array}
V π ( s i ) = E π [ r ( s i , a i ) + γ V π ( s i + 1 ) ] Q π ( s i , a i ) = E π [ r ( s i , a i ) + γ Q π ( s i + 1 , a i + 1 ) ]
既然我们的目标是找到最优的政策 π ∗ \pi* π ∗
V ∗ ( s i ) = max a i ∈ A E π [ r ( s i , a i ) + γ V π ( s i + 1 ) ] . V_{*}\left(s_{i}\right)=\max _{a_{i} \in \mathcal{A}} \mathbb{E}_{\pi}\left[r\left(s_{i}, a_{i}\right)+\gamma V_{\pi}\left(s_{i+1}\right)\right] .
V ∗ ( s i ) = a i ∈ A max E π [ r ( s i , a i ) + γ V π ( s i + 1 ) ] .
最优行为值函数也遵循最优策略 π ∗ \pi* π ∗ Q ∗ Q_* Q ∗ V ∗ V_* V ∗
Q ∗ ( s i , a i ) = E π [ r ( s i , a i ) + γ V ∗ ( s i + 1 ) ] Q_{*}\left(s_{i}, a_{i}\right)=\mathbb{E}_{\pi}\left[r\left(s_{i}, a_{i}\right)+\gamma V_{*}\left(s_{i+1}\right)\right]
Q ∗ ( s i , a i ) = E π [ r ( s i , a i ) + γ V ∗ ( s i + 1 ) ]
3.1.2 Q-learning
RL是机器学习的一个重要分支,agent通过与控制环境交互,使其达到最优状态,从而获得最大的收益。虽然RL常用于解决 MDPs 的优化问题,但潜在传播概率 p ( s i + 1 ∣ s i , a i ) p(s_{i+1}|s_i,a_i) p ( s i + 1 ∣ s i , a i )
Q ∗ ( s i , a i ) = E π [ r ( s i , a i ) + γ max a i + 1 Q ∗ ( s i + 1 , a i + 1 ) ] Q_{*}\left(s_{i}, a_{i}\right)=\mathbb{E}_{\pi}\left[r\left(s_{i}, a_{i}\right)+\gamma \max _{a_{i+1}} Q_{*}\left(s_{i+1}, a_{i+1}\right)\right]
Q ∗ ( s i , a i ) = E π [ r ( s i , a i ) + γ a i + 1 max Q ∗ ( s i + 1 , a i + 1 ) ]
通过迭代过程可以找到Q函数的最优值。agent从经验元组 ( s i , a i , r i , s i + 1 ) (s_i,a_i,r_i,s_{i+1}) ( s i , a i , r i , s i + 1 )
Q ( s i , a i ) ← Q ( s i , a i ) + α [ r ( s i , a i ) + γ max a i + 1 Q ( s i + 1 , a i + 1 ) − Q ( s i , a i ) ] Q(s_{i}, a_{i}) \leftarrow Q(s_{i}, a_{i})+\alpha [ r(s_{i}, a_{i})+\gamma \max_{a_{i+1}} Q(s_{i+1}, a_{i+1})-Q(s_{i}, a_{i})]
Q ( s i , a i ) ← Q ( s i , a i ) + α [ r ( s i , a i ) + γ a i + 1 max Q ( s i + 1 , a i + 1 ) − Q ( s i , a i )]
其中, α \alpha α r ( s i , a i ) + γ max a i + 1 Q ( s i + 1 , a i + 1 ) r(s_{i}, a_{i})+\gamma \max_{a_{i+1}} Q(s_{i+1}, a_{i+1}) r ( s i , a i ) + γ max a i + 1 Q ( s i + 1 , a i + 1 ) Q ( s i , a i ) Q(s_{i}, a_{i}) Q ( s i , a i )
3.1.3 DQN
Q-learning算法通过维护一个查询表更新状态动作空间中各项的Q值,适用于状态动作空间较小的情况。**考虑到实际系统模型的复杂性,这些空间通常是非常大的。原因是大量状态很少被访问,对应的Q值很少更新,导致Q函数的收敛时间较长。**DQN通过将深度神经网络(DNNs)与q学习相结合,解决了Q-learning算法的不足。DQN的核心思想是利用 θ \theta θ Q ( s , a ) Q(s,a) Q ( s , a ) Q ( s , a ∣ θ ) ≈ Q ∗ ( s , a ) Q(s,a \mid \theta) \approx Q_{*}(s, a) Q ( s , a ∣ θ ) ≈ Q ∗ ( s , a )
但是使用 DNN 的 RL 算法的稳定性不能得到保证。为了解决这个问题,采用了两种机制。第一个是体验重放(experience replay) 。在每个时间步 i 中,agent的交互经验元组 ( s i , a i , r i , s i + 1 ) \left(s_{i}, a_{i}, r_{i}, s_{i+1}\right) ( s i , a i , r i , s i + 1 ) B m B_m B m 第二种稳定方法是使用一个目标网络 ,它最初包含了设定策略的网络的权值,但在固定的时间步长内保持冻结状态。目标Q网络更新缓慢,但主Q网络更新频繁。这样大大降低了目标与估计Q值之间的相关性,使得算法更加稳定。
在每次迭代中,通过最小化损失函数 L ( θ ) L(\theta) L ( θ )
L ( θ ) = E [ ( y − Q ( s , a ∣ θ ) ) 2 ] L(\theta)=\mathbb{E}\left[(y-Q(s, a \mid \theta))^{2}\right]
L ( θ ) = E [ ( y − Q ( s , a ∣ θ ) ) 2 ]
其中目标值 y 表示为 y = r + γ max a ′ Q ( s ′ , a ′ ∣ θ i − ) y=r+\gamma \max _{a^{\prime}} Q\left(s^{\prime}, a^{\prime} \mid \theta_{i}^{-}\right) y = r + γ max a ′ Q ( s ′ , a ′ ∣ θ i − ) θ i − = θ i − 1 \theta_{i}^{-}=\theta_{i-1} θ i − = θ i − 1 θ i − = θ 1 − X \theta_{i}^{-}=\theta_{1-X} θ i − = θ 1 − X
3.1.4 DDPG
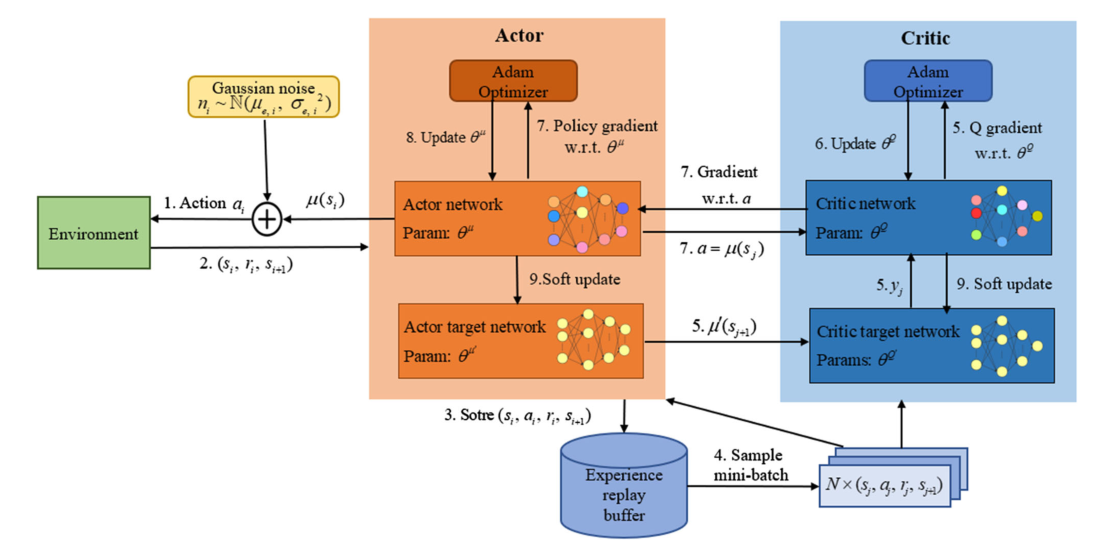
**DQN算法虽然可以解决高维状态空间的问题,但仍然不能处理连续的动作空间。DDPG算法是一种基于DNN的无模型的 off-policy actor - critic算法,可以学习连续动作空间中的策略。**该算法由策略函数和 q 值函数组成。策略函数扮演一个参与者来生成动作。q 值函数作为一个批评家,评价行为人的表现,并指导行为人的后续行动。
如图1所示,DDPG使用两个不同的 DNNs 来逼近actor网络 μ ( s ∣ θ μ ) \mu\left(s\mid \theta^{\mu}\right) μ ( s ∣ θ μ ) Q ( s , a ∣ θ Q ) Q\left(s, a \mid \theta^{Q}\right) Q ( s , a ∣ θ Q ) θ μ ′ \theta^{\mu^{\prime}} θ μ ′ μ ′ \mu^{\prime} μ ′ θ Q ′ \theta^{Q^{\prime}} θ Q ′ Q ′ Q^{\prime} Q ′ Q ( s , a ∣ θ Q ) Q\left(s, a \mid \theta^{Q}\right) Q ( s , a ∣ θ Q )
L ( θ Q ) = E μ ′ [ ( y i − Q ( s i , a i ∣ θ Q ) ) 2 ] L\left(\theta^{Q}\right)=\mathbb{E}_{\mu^{\prime}}\left[\left(y_{i}-Q\left(s_{i}, a_{i} \mid \theta^{Q}\right)\right)^{2}\right]
L ( θ Q ) = E μ ′ [ ( y i − Q ( s i , a i ∣ θ Q ) ) 2 ]
其中,
y i = r i + γ Q ( s i + 1 , μ ( s i + 1 ) ∣ θ Q ) y_{i}=r_{i}+\gamma Q\left(s_{i+1}, \mu\left(s_{i+1}\right) \mid \theta^{Q}\right)
y i = r i + γ Q ( s i + 1 , μ ( s i + 1 ) ∣ θ Q )
正如Silver等人所证明的,策略梯度可以用链式法则更新,
∇ θ μ J ≈ E μ ′ [ ∇ θ μ Q ( s , a ∣ θ Q ) ∣ s = s i , a = μ ( s i ∣ θ μ ) ] = E μ ′ [ ∇ a Q ( s , a ∣ θ Q ) ∣ s = s i , a = μ ( s i ∣ θ μ ) ∇ θ μ μ ( s ∣ θ μ ) ∣ s = s i ] . \begin{array}{r} \nabla_{\theta^{\mu}} J \approx \mathbb{E}_{\mu^{\prime}}\left[\left.\nabla_{\theta^{\mu}} Q\left(s, a \mid \theta^{Q}\right)\right|_{s=s_{i}, a=\mu\left(s_{i} \mid \theta^{\mu}\right)}\right] \\ =\mathbb{E}_{\mu^{\prime}}\left[\left.\left.\nabla_{a} Q\left(s, a \mid \theta^{Q}\right)\right|_{s=s_{i}, a=\mu\left(s_{i} \mid \theta^{\mu}\right)} \nabla_{\theta^{\mu}} \mu\left(s \mid \theta^{\mu}\right)\right|_{s=s_{i}}\right] . \end{array}
∇ θ μ J ≈ E μ ′ [ ∇ θ μ Q ( s , a ∣ θ Q ) s = s i , a = μ ( s i ∣ θ μ ) ] = E μ ′ [ ∇ a Q ( s , a ∣ θ Q ) s = s i , a = μ ( s i ∣ θ μ ) ∇ θ μ μ ( s ∣ θ μ ) s = s i ] .
DDPG 算法的整个训练过程可以总结如下:首先,演员网络 μ \mu μ μ ( s i ) \mu(s_i) μ ( s i ) n i n_i n i a i = μ ( s i ) + n i a_i=\mu(s_i)+n_i a i = μ ( s i ) + n i n i n_i n i n i ∼ N ( μ e , σ e , i 2 ) n_{i} \sim \mathbb{N}\left(\mu_{e}, \sigma_{e, i}^{2}\right) n i ∼ N ( μ e , σ e , i 2 ) μ e \mu_e μ e σ e , i \sigma_{e, i} σ e , i a t a_t a t s i + 1 s_{i+1} s i + 1 r t r_t r t ( s i , a i , r i , s i + 1 ) \left(s_{i}, a_{i}, r_{i}, s_{i+1}\right) ( s i , a i , r i , s i + 1 ) ( s j , a j , r j , s j + 1 ) (s_j,a_j,r_j,s_{j+1}) ( s j , a j , r j , s j + 1 ) μ ′ \mu^{\prime} μ ′ μ ′ ( s j + 1 ) \mu^{\prime}(s_{j+1}) μ ′ ( s j + 1 ) Q ′ Q^{\prime} Q ′ μ ′ ( s j + 1 ) \mu^{\prime}(s_{j+1}) μ ′ ( s j + 1 ) y i = r i + γ Q ( s i + 1 , μ ( s i + 1 ) ∣ θ Q ) y_{i}=r_{i}+\gamma Q\left(s_{i+1}, \mu\left(s_{i+1}\right) \mid \theta^{Q}\right) y i = r i + γ Q ( s i + 1 , μ ( s i + 1 ) ∣ θ Q ) y j y_j y j
**为了使损失函数最小化,批评家网络Q将由给定的优化器(如Adam optimizer)进行更新。**然后,演员网络 μ \mu μ a = μ ( s j ) a=\mu(s_j) a = μ ( s j ) ∇ a Q ( s , a ∣ θ Q ) ∣ s = s j , a = μ ( s j ) \left.\nabla_{a} Q\left(s, a \mid \theta^{Q}\right)\right|_{s=s_{j}, a=\mu\left(s_{j}\right)} ∇ a Q ( s , a ∣ θ Q ) s = s j , a = μ ( s j ) ∇ θ μ μ ( s ∣ θ μ ) ∣ s = s j \left.\nabla_{\theta^{\mu}} \mu\left(s \mid \theta^{\mu}\right)\right|_{s=s_{j}} ∇ θ μ μ ( s ∣ θ μ ) ∣ s = s j
∇ θ u J ≈ 1 N ∑ j [ ∇ a Q ( s , a ∣ θ Q ) ∣ s = s j , a = μ ( s j ∣ θ μ ) ∇ θ μ μ ( s ∣ θ μ ) ∣ s = s j ] . \nabla_{\theta^{u}} J \approx \frac{1}{N} \sum_{j}\left[\left.\left.\nabla_{a} Q\left(s, a \mid \theta^{Q}\right)\right|_{s=s_{j}, a=\mu\left(s_{j} \mid \theta^{\mu}\right)} \nabla_{\theta^{\mu}} \mu\left(s \mid \theta^{\mu}\right)\right|_{s=s_{j}}\right] .
∇ θ u J ≈ N 1 j ∑ [ ∇ a Q ( s , a ∣ θ Q ) s = s j , a = μ ( s j ∣ θ μ ) ∇ θ μ μ ( s ∣ θ μ ) s = s j ] .
最后,DDPG agent使用小常数 τ \tau τ
θ Q ′ ← θ Q + ( 1 − τ ) θ Q ′ θ μ ′ ← θ μ + ( 1 − τ ) θ μ ′ \begin{array}{l} \theta^{Q^{\prime}} \leftarrow \theta^{Q}+(1-\tau) \theta^{Q^{\prime}} \\ \theta^{\mu^{\prime}} \leftarrow \theta^{\mu}+(1-\tau) \theta^{\mu^{\prime}} \end{array}
θ Q ′ ← θ Q + ( 1 − τ ) θ Q ′ θ μ ′ ← θ μ + ( 1 − τ ) θ μ ′