无人机辅助移动边缘计算的计算卸载优化:一种深度确定性策略梯度方法
摘要:无人机(UAV)可以在无线系统中发挥重要作用,因为它可以灵活地部署,帮助提高通信的覆盖和质量。本文研究了一种无人机辅助的移动边缘计算(MEC)系统,在该系统中,无人机配备了计算资源,可以为附近的用户设备提供卸载服务。终端将部分计算任务卸载给无人机,其余计算任务在终端本地执行。在离散变量和能量消耗约束下,通过联合优化用户调度、任务卸载率、无人机飞行角度和飞行速度,以最小化最大处理延迟为目标。考虑到该问题中高维状态空间和连续动作空间的非凸性,提出了一种基于深度确定性策略梯度(DDPG)的强化学习算法。利用该算法,我们可以在不可控的动态环境下得到最优的计算卸载策略。实验结果表明,该算法能够快速收敛到最优解。与此同时,我们的算法在处理延迟方面比基线算法(如深度Q网络(DQN))有很大的提高。
1 介绍
1.1 动机
随着5G技术的发展,运行在用户设备(User Equipment,UE)上的计算密集型应用,如网络游戏、VR/AR和远程医疗,将变得更加繁荣和流行。这些移动应用通常需要大量的计算资源和高能耗。然而,目前的终端普遍存在计算资源和电池容量的限制 。移动云计算(MCC)是为了提高终端的计算和存储能力 ,并通过移动网络将计算转移到云端 ,从而降低终端的能耗 而出现的。但由于云服务器与终端之间的空间距离较远,导致传输延迟较大 ,影响用户体验。为了减少回程链路延迟,移动计算最近转向了一种新的计算范式,即移动边缘计算(Mobile Edge Computing, MEC) 。MEC可以将云计算资源和业务迁移到离终端更近的地方,从而有效降低通信延迟和能耗。
早期对 MEC 的研究主要集中于提高 MEC 系统的性能,在 MEC 系统中,计算服务由固定位置的基站提供。例如, Tran 等人在多用户多服务器的 MEC 系统中提出了一种用于优化资源分配的凸优化方法和一种用于任务卸载的低复杂度启发式算法。Zhao等人的目标是在云辅助的 MEC 系统中通过协同计算卸载和资源分配优化(CCORAO)方案实现系统效用最大化。为了降低基于多用户 MIMO 的 MEC 系统的计算成本,Chen等人提出了一种深度强化学习方法来动态生成连续功率分配策略。但是,固定基础设施提供的MEC服务在通信设施稀疏或发生突发性自然灾害的情况下无法有效工作。
近年来,无人机(Unmanned Aerial Vehicle,简称UAV)以其高机动性、部署灵活等特点受到了广泛的关注。他们研究了无人机辅助MEC系统中的资源分配或路径规划。针对无人机辅助MEC系统中终端间的处理延迟,Hu等开发了一种基于惩罚对偶分解优化框架的算法,通过联合优化无人机轨迹、计算卸载和用户调度。刁等设计了一种基于节能的联合无人机轨迹和任务数据分配优化算法。Cheng等人提出了一种新的边缘计算体系结构——无人机辅助空对地综合网络(SAGIN),并设计了一种基于行为者批评的强化学习(RL)算法用于资源分配和任务调度。在基于无人机的MEC系统中,考虑到状态空间的维数灾难,Li等人采用了RL算法来提高UEs任务迁移的吞吐量。Xiong等提出了一种通过联合优化卸载决策、钻头分配和无人机轨迹来降低能耗的优化算法。Selim et al.提出使用设备到设备(D2D)作为无人机- mec系统辅助通信和计算卸载的附加选项。在广泛的研究和应用中,无人机辅助的MEC系统仍然面临着许多挑战,例如, UE 计算能力的限制和环境障碍物(如树木或建筑物)的阻塞严重影响了系统性能,特别是在城市地区。因此,自适应链路选择和任务卸载问题在无人机辅助的 MEC 系统中是非常重要的。
1.2 新颖性与贡献
在本文中,我们考虑了一个由安装有纳米服务器的无人机和多个终端组成的MEC系统,其中通信条件是动态和时变的。与基于深度Q网络(DQN)的离散动作空间算法不同,本文设计了一种新的基于深度确定性策略梯度(DDPG)的计算卸载算法,该算法能够有效支持任务卸载和无人机机动的连续动作空间。本文的主要贡献如下:
考虑时变信道状态下的分时段无人机辅助MEC系统,联合优化用户调度、无人机机动性和资源分配,将非凸计算卸载问题定义为马尔可夫决策过程(MDP)问题 ,以最小化处理延迟。
当我们考虑MDP模型时,系统状态的复杂性非常高。此外,计算卸载的决策需要对连续动作空间的支持 。因此,我们提出了一种新的基于DDPG的计算卸载方法。DDPG是一种先进的强化学习算法,它利用行动者网络生成独特的动作,利用批评网络逼近q值动作函数。本文采用 DDPG 算法对无人机辅助 MEC 系统中的用户调度、无人机机动性和资源分配进行优化。
DDPG算法是在 TensorFlow 平台上实现的。不同系统参数下的仿真结果验证了该算法的有效性。在不同的通信条件下,与其他基线算法相比,我们的算法总能取得最好的性能。
本文的其余部分组织如下。第二节介绍了无人机辅助 MEC 系统的系统模型,以及优化问题。第3节简要介绍了深度强化学习的初步研究。第四节提出了基于 DDPG 的计算卸载算法。第 5 节给出了我们提出的算法的仿真结果,并与其他基线算法进行了比较。最后,第六节总结了本工作。
2 系统模型
我们考虑了一种无人机辅助的MEC系统,该系统由UE和配备纳米MEC服务器的无人机组成。整个系统运行在离散时间内,时隙长度相等。对所有终端提供通信和计算服务,但一次只能对一个终端。由于计算能力的限制,终端必须通过无线网络将部分计算任务转移到无人机的MEC服务器上。
2.1 通信模型
无人机以时间划分方式向所有终端提供计算服务,将整个通信周期 T 划分为 I 个时隙。我们假设 UEs 在该区域内以低速随机移动。在每个时间段,无人机在固定位置悬停,然后与其中一个终端建立通信。终端将部分计算任务卸载到服务器上后,剩余的计算任务将在本地执行。在三维笛卡尔坐标系下,无人机保持在固定高度 H 飞行,无人机的起始坐标 q ( i ) = [ x ( i ) , y ( i ) ] T ∈ R ( 2 × 1 ) q(i)=[x(i), y(i)]^T \in R^{(2 \times 1)} q ( i ) = [ x ( i ) , y ( i ) ] T ∈ R ( 2 × 1 ) q ( i + 1 ) = [ x ( i + 1 ) , y ( i + 1 ) ] T ∈ R ( 2 × 1 ) q(i+1)=[x(i+1), y(i+1)]^T \in R^{(2 \times 1)} q ( i + 1 ) = [ x ( i + 1 ) , y ( i + 1 ) ] T ∈ R ( 2 × 1 ) i ∈ { 1 , 2 , ⋯ , I } i \in \{1,2, \cdots,I\} i ∈ { 1 , 2 , ⋯ , I } k ∈ { 1 , 2 , ⋯ , K } k \in \{1,2, \cdots,K\} k ∈ { 1 , 2 , ⋯ , K } p k ( i ) = [ x k ( i ) , y k ( i ) ] T ∈ R ( 2 × 1 ) p_k(i)=[x_k(i), y_k(i)]^T \in R^{(2 \times 1)} p k ( i ) = [ x k ( i ) , y k ( i ) ] T ∈ R ( 2 × 1 )
g k ( i ) = α 0 d k − 2 ( i ) = α 0 ∣ ∣ q ( i + 1 ) − p k ( i ) ∣ ∣ 2 + H 2 g_k(i) = \alpha_0 d_k^{-2}(i) = \frac{\alpha_0}{||q(i+1)-p_k(i)||^2+H^2}
g k ( i ) = α 0 d k − 2 ( i ) = ∣∣ q ( i + 1 ) − p k ( i ) ∣ ∣ 2 + H 2 α 0
式中,α 0 \alpha_0 α 0 d = 1 m d=1m d = 1 m d k ( i ) d_k(i) d k ( i )
r k ( i ) = B l o g 2 ( 1 + P u p g k ( i ) σ 2 + f k ( i ) P N L O S ) r_k(i) = B log_2(1+\frac{P_{up}g_k(i)}{\sigma^2+f_k(i)P_{NLOS}})
r k ( i ) = B l o g 2 ( 1 + σ 2 + f k ( i ) P N L O S P u p g k ( i ) )
B 表示通信带宽, P u p P_{up} P u p σ 2 \sigma^2 σ 2 P N L O S P_{NLOS} P N L O S f k ( i ) f_k(i) f k ( i )
2.2 计算模型
在我们的MEC系统中,在每个时隙中对终端的任务使用了部分卸载策略。设 R k ( i ) ∈ [ 0 , 1 ] R_k(i) \in [0,1] R k ( i ) ∈ [ 0 , 1 ] ( 1 − R k ( i ) ) (1-R_k(i)) ( 1 − R k ( i ))
t l o c a l , k ( i ) = ( 1 − R k ( i ) ) D k ( i ) s f U E t_{local,k}(i) = \frac{(1-R_k(i))D_k(i)s}{f_{UE}}
t l oc a l , k ( i ) = f U E ( 1 − R k ( i )) D k ( i ) s
其中, D k ( i ) D_k(i) D k ( i ) f U E f_{UE} f U E
q ( i + 1 ) = [ x ( i ) + v ( i ) t f l y cos β ( i ) , y ( i ) + v ( i ) t f l y sin β ( i ) ] T \mathbf{q}(i+1)=\left[x(i)+v(i) t_{fly} \cos \beta(i), y(i)+v(i) t_{fly} \sin \beta(i)\right]^{T}
q ( i + 1 ) = [ x ( i ) + v ( i ) t f l y cos β ( i ) , y ( i ) + v ( i ) t f l y sin β ( i ) ] T
其中,速度为 v ( i ) ∈ [ 0 , v m a x ] v(i) \in [0,v_{max}] v ( i ) ∈ [ 0 , v ma x ] β ( i ) ∈ [ 0 , 2 π ] \beta(i) \in [0, 2\pi] β ( i ) ∈ [ 0 , 2 π ]
E f l y ( i ) = ϕ ∣ ∣ v ( i ) ∣ ∣ 2 E_{fly}(i) = \phi||v(i)||^2
E f l y ( i ) = ϕ ∣∣ v ( i ) ∣ ∣ 2
其中 ϕ = 0.5 M U A V t f l y \phi=0.5 M_{UAV} t_{fly} ϕ = 0.5 M U A V t f l y t f l y t_{fly} t f l y
t t r , k ( i ) = R k ( i ) D k ( i ) r k ( i ) t_{t r, k}(i)=\frac{R_{k}(i) D_{k}(i)}{r_{k}(i)}
t t r , k ( i ) = r k ( i ) R k ( i ) D k ( i )
另一部分是在MEC服务器上计算产生的延迟,可以表示为:
t U A V , k ( i ) = R k ( i ) D k ( i ) s f U A V t_{U A V, k}(i)=\frac{R_{k}(i) D_{k}(i) s}{f_{U A V}}
t U A V , k ( i ) = f U A V R k ( i ) D k ( i ) s
其中 f U A V f_{U A V} f U A V
P U A V , k ( i ) = κ f U A V 3 P_{U A V, k}(i)=\kappa f_{U A V}^{3}
P U A V , k ( i ) = κ f U A V 3
则 MEC 服务器在第 i 时刻的能耗为:
E U A V , k ( i ) = P U A V , k ( i ) t U A V , k ( i ) = κ f U A V 2 R k ( i ) D k ( i ) s E_{U A V, k}(i)=P_{U A V, k}(i) t_{U A V, k}(i)=\kappa f_{U A V}^{2} R_{k}(i) D_{k}(i) s
E U A V , k ( i ) = P U A V , k ( i ) t U A V , k ( i ) = κ f U A V 2 R k ( i ) D k ( i ) s
2.3 问题公式化
在此基础上,提出了无人机辅助MEC系统的优化问题。为了确保有限的计算资源的有效利用,我们的目标是通过联合优化用户调度、无人机机动性和系统中的资源分配,使所有终端的最大处理延迟最小化 。具体而言,优化问题可以表示为:
min { α k ( i ) , q ( i + 1 ) , R k ( i ) } ∑ i = 1 I ∑ k = 1 K α k ( i ) max { t l o c a l , k ( i ) , t U A V , k ( i ) + t t r , k ( i ) } s.t. α k ( i ) ∈ { 0 , 1 } , ∀ i ∈ { 1 , 2 , … , I } , k ∈ { 1 , 2 , … , K } , ∑ k = 1 K α k ( i ) = 1 , ∀ i , 0 ≤ R k ( i ) ≤ 1 , ∀ i , k , q ( i ) ∈ { ( x ( i ) , y ( i ) ) ∣ x ( i ) ∈ [ 0 , L ] , y ∈ [ 0 , W ] } , ∀ i , p ( i ) ∈ { ( x k ( i ) , y k ( i ) ) ∣ x k ( i ) ∈ [ 0 , L ] , y k ∈ [ 0 , W ] } , ∀ i , k , f k ( i ) ∈ { 0 , 1 } , ∀ i , k , ∑ i = 1 I ( E f l y , k ( i ) + E U A V , k ( i ) ) ≤ E b , ∀ k , ∑ i = 1 I ∑ k = 1 K α k ( i ) D k ( i ) = D \min _{\left\{\alpha_{k}(i), \mathbf{q}(i+1), R_{k}(i)\right\}} \sum_{i=1}^{I} \sum_{k=1}^{K} \alpha_{k}(i) \max \left\{t_{l o c a l, k}(i), t_{U A V, k}(i)+t_{t r, k}(i)\right\} \\ \text { s.t. } \alpha_{k}(i) \in\{0,1\}, \forall i \in\{1,2, \ldots, I\}, k \in\{1,2, \ldots, K\}, \\ \sum_{k=1}^{K} \alpha_{k}(i)=1, \forall i, \\ 0 \leq R_{k}(i) \leq 1, \forall i, k, \\ \mathbf{q}(i) \in\{(x(i), y(i)) \mid x(i) \in[0, L], y \in[0, W]\}, \forall i, \\ \mathbf{p}(i) \in\left\{\left(x_{k}(i), y_{k}(i)\right) \mid x_{k}(i) \in[0, L], y_{k} \in[0, W]\right\}, \forall i, k, \\ f_{k}(i) \in\{0,1\}, \forall i, k , \\ \sum_{i=1}^{I}\left(E_{f l y, k}(i)+E_{U A V, k}(i)\right) \leq E_{b}, \forall k , \\ \sum_{i=1}^{I} \sum_{k=1}^{K} \alpha_{k}(i) D_{k}(i)=D
{ α k ( i ) , q ( i + 1 ) , R k ( i ) } min i = 1 ∑ I k = 1 ∑ K α k ( i ) max { t l oc a l , k ( i ) , t U A V , k ( i ) + t t r , k ( i ) } s.t. α k ( i ) ∈ { 0 , 1 } , ∀ i ∈ { 1 , 2 , … , I } , k ∈ { 1 , 2 , … , K } , k = 1 ∑ K α k ( i ) = 1 , ∀ i , 0 ≤ R k ( i ) ≤ 1 , ∀ i , k , q ( i ) ∈ {( x ( i ) , y ( i )) ∣ x ( i ) ∈ [ 0 , L ] , y ∈ [ 0 , W ]} , ∀ i , p ( i ) ∈ { ( x k ( i ) , y k ( i ) ) ∣ x k ( i ) ∈ [ 0 , L ] , y k ∈ [ 0 , W ] } , ∀ i , k , f k ( i ) ∈ { 0 , 1 } , ∀ i , k , i = 1 ∑ I ( E f l y , k ( i ) + E U A V , k ( i ) ) ≤ E b , ∀ k , i = 1 ∑ I k = 1 ∑ K α k ( i ) D k ( i ) = D
其中,等式 (9b)和等式 (9c)保证在第 i 个时间段只有一个用户被调度到计算中。等式 (9d)为计算任务卸载率的取值范围。约束(9e)和(9f)表示 UE 和 UAV 只能在给定区域内移动。约束(9g)表示无人机与终端之间的无线信道在 i 时隙被堵塞。约束(9h)保证无人机在所有时隙飞行和计算的能耗不超过最大电池容量。约束(9i)指定整个时间段内需要完成的所有计算任务。
3 基于DDPG的计算卸载优化
在本节中,我们首先介绍 MDP 、 Q-Learning 、 DQN 和 DDPG 这些重要的新兴 RL 技术的基本知识。然后,讨论了如何利用 DDPG 来训练无人机辅助MEC系统的高效计算卸载策略。详细地定义了状态空间、动作空间和奖励函数,描述了数据预处理的状态归一化,并举例说明了训练算法和测试算法的过程。
3.1 RL介绍
3.1.1 MDP
MDP 是描述离散时间随机控制过程的数学框架,在该过程中,结果是部分随机的,并且处于主体或决策者的控制下。它正式地描述了一个环境,它是完全可观察到的强化学习。通常, MDP 可以定义为一个元组 ( S , A , p ( . , . ) , r ) (\mathcal{S}, \mathcal{A}, p(.,.), r) ( S , A , p ( . , . ) , r ) p ( s i + 1 ∣ s i , a i ) p(s_{i+1}|s_i,a_i) p ( s i + 1 ∣ s i , a i ) a i ∈ A a_i \in \mathcal{A} a i ∈ A s i ∈ S s_i \in \mathcal S s i ∈ S s i + 1 ∈ S s_{i+1} \in \mathcal S s i + 1 ∈ S
R i = ∑ l = i ∞ γ l − i r l R_{i}=\sum_{l=i}^{\infty} \gamma^{l-i} r_{l}
R i = l = i ∑ ∞ γ l − i r l
其中, γ ∈ [ 0 , 1 ] \gamma \in [0, 1] γ ∈ [ 0 , 1 ] r l = r ( s l , a l ) r_{l}=r(s_l,a_l) r l = r ( s l , a l ) l l l π \pi π s i s_i s i
V π ( s i ) = E π [ R i ∣ s i ] V_{\pi}\left(s_{i}\right)=\mathbb{E}_{\pi}\left[R_{i} \mid s_{i}\right]
V π ( s i ) = E π [ R i ∣ s i ]
同样,在策略 π \pi π s i s_i s i a i a_i a i
Q π ( s i ) = E π [ R i ∣ s i , a i ] Q_{\pi}\left(s_{i}\right)=\mathbb{E}_{\pi}\left[R_{i} \mid s_{i}, a_{i}\right]
Q π ( s i ) = E π [ R i ∣ s i , a i ]
根据 Bellman 方程,状态值函数和动作值函数的递归关系分别表示为:
V π ( s i ) = E π [ r ( s i , a i ) + γ V π ( s i + 1 ) ] Q π ( s i , a i ) = E π [ r ( s i , a i ) + γ Q π ( s i + 1 , a i + 1 ) ] \begin{array}{l} V_{\pi}\left(s_{i}\right)=\mathbb{E}_{\pi}\left[r\left(s_{i}, a_{i}\right)+\gamma V_{\pi}\left(s_{i+1}\right)\right] \\ Q_{\pi}\left(s_{i}, a_{i}\right)=\mathbb{E}_{\pi}\left[r\left(s_{i}, a_{i}\right)+\gamma Q_{\pi}\left(s_{i+1}, a_{i+1}\right)\right] \end{array}
V π ( s i ) = E π [ r ( s i , a i ) + γ V π ( s i + 1 ) ] Q π ( s i , a i ) = E π [ r ( s i , a i ) + γ Q π ( s i + 1 , a i + 1 ) ]
既然我们的目标是找到最优的政策 π ∗ \pi* π ∗
V ∗ ( s i ) = max a i ∈ A E π [ r ( s i , a i ) + γ V π ( s i + 1 ) ] . V_{*}\left(s_{i}\right)=\max _{a_{i} \in \mathcal{A}} \mathbb{E}_{\pi}\left[r\left(s_{i}, a_{i}\right)+\gamma V_{\pi}\left(s_{i+1}\right)\right] .
V ∗ ( s i ) = a i ∈ A max E π [ r ( s i , a i ) + γ V π ( s i + 1 ) ] .
最优行为值函数也遵循最优策略 π ∗ \pi* π ∗ Q ∗ Q_* Q ∗ V ∗ V_* V ∗
Q ∗ ( s i , a i ) = E π [ r ( s i , a i ) + γ V ∗ ( s i + 1 ) ] Q_{*}\left(s_{i}, a_{i}\right)=\mathbb{E}_{\pi}\left[r\left(s_{i}, a_{i}\right)+\gamma V_{*}\left(s_{i+1}\right)\right]
Q ∗ ( s i , a i ) = E π [ r ( s i , a i ) + γ V ∗ ( s i + 1 ) ]
3.1.2 Q-learning
RL是机器学习的一个重要分支,agent通过与控制环境交互,使其达到最优状态,从而获得最大的收益。虽然RL常用于解决 MDPs 的优化问题,但潜在传播概率 p ( s i + 1 ∣ s i , a i ) p(s_{i+1}|s_i,a_i) p ( s i + 1 ∣ s i , a i )
Q ∗ ( s i , a i ) = E π [ r ( s i , a i ) + γ max a i + 1 Q ∗ ( s i + 1 , a i + 1 ) ] Q_{*}\left(s_{i}, a_{i}\right)=\mathbb{E}_{\pi}\left[r\left(s_{i}, a_{i}\right)+\gamma \max _{a_{i+1}} Q_{*}\left(s_{i+1}, a_{i+1}\right)\right]
Q ∗ ( s i , a i ) = E π [ r ( s i , a i ) + γ a i + 1 max Q ∗ ( s i + 1 , a i + 1 ) ]
通过迭代过程可以找到Q函数的最优值。agent从经验元组 ( s i , a i , r i , s i + 1 ) (s_i,a_i,r_i,s_{i+1}) ( s i , a i , r i , s i + 1 )
Q ( s i , a i ) ← Q ( s i , a i ) + α [ r ( s i , a i ) + γ max a i + 1 Q ( s i + 1 , a i + 1 ) − Q ( s i , a i ) ] Q(s_{i}, a_{i}) \leftarrow Q(s_{i}, a_{i})+\alpha [ r(s_{i}, a_{i})+\gamma \max_{a_{i+1}} Q(s_{i+1}, a_{i+1})-Q(s_{i}, a_{i})]
Q ( s i , a i ) ← Q ( s i , a i ) + α [ r ( s i , a i ) + γ a i + 1 max Q ( s i + 1 , a i + 1 ) − Q ( s i , a i )]
其中, α \alpha α r ( s i , a i ) + γ max a i + 1 Q ( s i + 1 , a i + 1 ) r(s_{i}, a_{i})+\gamma \max_{a_{i+1}} Q(s_{i+1}, a_{i+1}) r ( s i , a i ) + γ max a i + 1 Q ( s i + 1 , a i + 1 ) Q ( s i , a i ) Q(s_{i}, a_{i}) Q ( s i , a i )
3.1.3 DQN
Q-learning 算法通过维护一个查询表更新状态动作空间中各项的Q值,适用于状态动作空间较小的情况。考虑到实际系统模型的复杂性,这些空间通常是非常大的。原因是大量状态很少被访问,对应的 Q 值很少更新,导致Q函数的收敛时间较长。 DQN 通过将深度神经网络(DNNs)与Q-learning算法相结合,解决了Q-learning算法的不足。DQN的核心思想是利用 θ \theta θ Q ( s , a ) Q(s,a) Q ( s , a ) Q ( s , a ∣ θ ) ≈ Q ∗ ( s , a ) Q(s,a \mid \theta) \approx Q_{*}(s, a) Q ( s , a ∣ θ ) ≈ Q ∗ ( s , a )
但是使用 DNN 的 RL 算法的稳定性不能得到保证。为了解决这个问题,采用了两种机制。第一个是体验重放(experience replay)。在每个时间步 i 中,agent的交互经验元组 ( s i , a i , r i , s i + 1 ) \left(s_{i}, a_{i}, r_{i}, s_{i+1}\right) ( s i , a i , r i , s i + 1 ) B m B_m B m
在每次迭代中,通过最小化损失函数 L ( θ ) L(\theta) L ( θ )
L ( θ ) = E [ ( y − Q ( s , a ∣ θ ) ) 2 ] L(\theta)=\mathbb{E}\left[(y-Q(s, a \mid \theta))^{2}\right]
L ( θ ) = E [ ( y − Q ( s , a ∣ θ ) ) 2 ]
其中目标值 y 表示为 y = r + γ max a ′ Q ( s ′ , a ′ ∣ θ i − ) y=r+\gamma \max _{a^{\prime}} Q\left(s^{\prime}, a^{\prime} \mid \theta_{i}^{-}\right) y = r + γ max a ′ Q ( s ′ , a ′ ∣ θ i − ) θ i − = θ i − 1 \theta_{i}^{-}=\theta_{i-1} θ i − = θ i − 1 θ i − = θ 1 − X \theta_{i}^{-}=\theta_{1-X} θ i − = θ 1 − X
3.1.4 DDPG
DQN算法虽然可以解决高维状态空间的问题,但仍然不能处理连续的动作空间。DDPG算法是一种基于DNN的无模型的off-policy actor - critic算法,可以学习连续动作空间中的策略。该算法由策略函数和q值函数组成。策略函数扮演一个参与者来生成动作。q值函数作为一个批评家,评价参与者的表现,并指导参与者的后续行动。
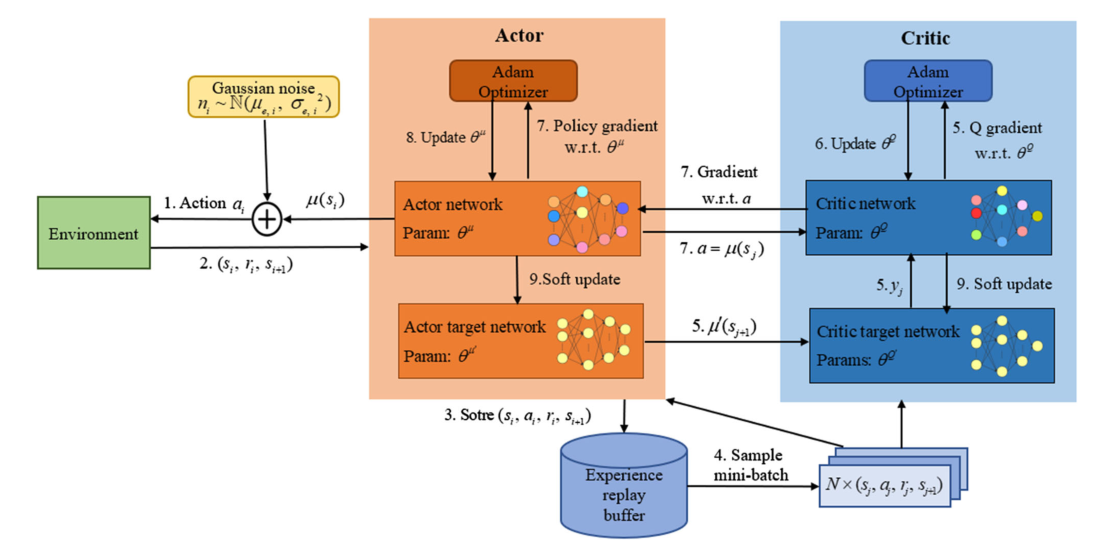
如图 1 所示,DDPG使用两个不同的 DNNs 来逼近actor网络 μ ( s ∣ θ μ ) \mu\left(s\mid \theta^{\mu}\right) μ ( s ∣ θ μ ) Q ( s , a ∣ θ Q ) Q\left(s, a \mid \theta^{Q}\right) Q ( s , a ∣ θ Q ) θ μ ′ \theta^{\mu^{\prime}} θ μ ′ μ ′ \mu^{\prime} μ ′ θ Q ′ \theta^{Q^{\prime}} θ Q ′ Q ′ Q^{\prime} Q ′ Q ( s , a ∣ θ Q ) Q\left(s, a \mid \theta^{Q}\right) Q ( s , a ∣ θ Q )
L ( θ Q ) = E μ ′ [ ( y i − Q ( s i , a i ∣ θ Q ) ) 2 ] L\left(\theta^{Q}\right)=\mathbb{E}_{\mu^{\prime}}\left[\left(y_{i}-Q\left(s_{i}, a_{i} \mid \theta^{Q}\right)\right)^{2}\right]
L ( θ Q ) = E μ ′ [ ( y i − Q ( s i , a i ∣ θ Q ) ) 2 ]
其中,
y i = r i + γ Q ( s i + 1 , μ ( s i + 1 ) ∣ θ Q ) y_{i}=r_{i}+\gamma Q\left(s_{i+1}, \mu\left(s_{i+1}\right) \mid \theta^{Q}\right)
y i = r i + γ Q ( s i + 1 , μ ( s i + 1 ) ∣ θ Q )
正如Silver等人所证明的,策略梯度可以用链式法则更新,
∇ θ μ J ≈ E μ ′ [ ∇ θ μ Q ( s , a ∣ θ Q ) ∣ s = s i , a = μ ( s i ∣ θ μ ) ] = E μ ′ [ ∇ a Q ( s , a ∣ θ Q ) ∣ s = s i , a = μ ( s i ∣ θ μ ) ∇ θ μ μ ( s ∣ θ μ ) ∣ s = s i ] . \begin{array}{r} \nabla_{\theta^{\mu}} J \approx \mathbb{E}_{\mu^{\prime}}\left[\left.\nabla_{\theta^{\mu}} Q\left(s, a \mid \theta^{Q}\right)\right|_{s=s_{i}, a=\mu\left(s_{i} \mid \theta^{\mu}\right)}\right] \\ =\mathbb{E}_{\mu^{\prime}}\left[\left.\left.\nabla_{a} Q\left(s, a \mid \theta^{Q}\right)\right|_{s=s_{i}, a=\mu\left(s_{i} \mid \theta^{\mu}\right)} \nabla_{\theta^{\mu}} \mu\left(s \mid \theta^{\mu}\right)\right|_{s=s_{i}}\right] . \end{array}
∇ θ μ J ≈ E μ ′ [ ∇ θ μ Q ( s , a ∣ θ Q ) s = s i , a = μ ( s i ∣ θ μ ) ] = E μ ′ [ ∇ a Q ( s , a ∣ θ Q ) s = s i , a = μ ( s i ∣ θ μ ) ∇ θ μ μ ( s ∣ θ μ ) s = s i ] .
DDPG 算法的整个训练过程可以总结如下:首先,演员网络 μ \mu μ μ ( s i ) \mu(s_i) μ ( s i ) n i n_i n i a i = μ ( s i ) + n i a_i=\mu(s_i)+n_i a i = μ ( s i ) + n i n i n_i n i n i ∼ N ( μ e , σ e , i 2 ) n_{i} \sim \mathbb{N}\left(\mu_{e}, \sigma_{e, i}^{2}\right) n i ∼ N ( μ e , σ e , i 2 ) μ e \mu_e μ e σ e , i \sigma_{e, i} σ e , i a t a_t a t s i + 1 s_{i+1} s i + 1 r t r_t r t ( s i , a i , r i , s i + 1 ) \left(s_{i}, a_{i}, r_{i}, s_{i+1}\right) ( s i , a i , r i , s i + 1 ) ( s j , a j , r j , s j + 1 ) (s_j,a_j,r_j,s_{j+1}) ( s j , a j , r j , s j + 1 ) μ ′ \mu^{\prime} μ ′ μ ′ ( s j + 1 ) \mu^{\prime}(s_{j+1}) μ ′ ( s j + 1 ) Q ′ Q^{\prime} Q ′ μ ′ ( s j + 1 ) \mu^{\prime}(s_{j+1}) μ ′ ( s j + 1 ) y i = r i + γ Q ( s i + 1 , μ ( s i + 1 ) ∣ θ Q ) y_{i}=r_{i}+\gamma Q\left(s_{i+1}, \mu\left(s_{i+1}\right) \mid \theta^{Q}\right) y i = r i + γ Q ( s i + 1 , μ ( s i + 1 ) ∣ θ Q ) y j y_j y j
为了使损失函数最小化,批评家网络Q将由给定的优化器(如Adam optimizer)进行更新。然后,演员网络 μ \mu μ a = μ ( s j ) a=\mu(s_j) a = μ ( s j ) ∇ a Q ( s , a ∣ θ Q ) ∣ s = s j , a = μ ( s j ) \left.\nabla_{a} Q\left(s, a \mid \theta^{Q}\right)\right|_{s=s_{j}, a=\mu\left(s_{j}\right)} ∇ a Q ( s , a ∣ θ Q ) s = s j , a = μ ( s j ) ∇ θ μ μ ( s ∣ θ μ ) ∣ s = s j \left.\nabla_{\theta^{\mu}} \mu\left(s \mid \theta^{\mu}\right)\right|_{s=s_{j}} ∇ θ μ μ ( s ∣ θ μ ) ∣ s = s j
∇ θ u J ≈ 1 N ∑ j [ ∇ a Q ( s , a ∣ θ Q ) ∣ s = s j , a = μ ( s j ∣ θ μ ) ∇ θ μ μ ( s ∣ θ μ ) ∣ s = s j ] . \nabla_{\theta^{u}} J \approx \frac{1}{N} \sum_{j}\left[\left.\left.\nabla_{a} Q\left(s, a \mid \theta^{Q}\right)\right|_{s=s_{j}, a=\mu\left(s_{j} \mid \theta^{\mu}\right)} \nabla_{\theta^{\mu}} \mu\left(s \mid \theta^{\mu}\right)\right|_{s=s_{j}}\right] .
∇ θ u J ≈ N 1 j ∑ [ ∇ a Q ( s , a ∣ θ Q ) s = s j , a = μ ( s j ∣ θ μ ) ∇ θ μ μ ( s ∣ θ μ ) s = s j ] .
最后,DDPG agent使用小常数 τ \tau τ
θ Q ′ ← θ Q + ( 1 − τ ) θ Q ′ θ μ ′ ← θ μ + ( 1 − τ ) θ μ ′ \begin{array}{l} \theta^{Q^{\prime}} \leftarrow \theta^{Q}+(1-\tau) \theta^{Q^{\prime}} \\ \theta^{\mu^{\prime}} \leftarrow \theta^{\mu}+(1-\tau) \theta^{\mu^{\prime}} \end{array}
θ Q ′ ← θ Q + ( 1 − τ ) θ Q ′ θ μ ′ ← θ μ + ( 1 − τ ) θ μ ′
4 DDPG-based算法
4.1 状态空间
在无人机辅助的MEC系统中,状态空间由 k 个用户、一个无人机及其环境共同确定。时间槽 i 处的系统状态可定义为:
s i = ( E battery ( i ) , q ( i ) , p 1 ( i ) , … , p K ( i ) , D remain ( i ) , D 1 ( i ) , … , D K ( i ) , f 1 ( i ) , … , f K ( i ) ) , \begin{aligned} s_{i}=&\left(E_{\text {battery }}(i), \mathbf{q}(i), \mathbf{p}_{1}(i), \ldots, \mathbf{p}_{K}(i), D_{\text {remain }}(i),\right.\\ &\left.D_{1}(i), \ldots, D_{K}(i), f_{1}(i), \ldots, f_{K}(i)\right), \end{aligned}
s i = ( E battery ( i ) , q ( i ) , p 1 ( i ) , … , p K ( i ) , D remain ( i ) , D 1 ( i ) , … , D K ( i ) , f 1 ( i ) , … , f K ( i ) ) ,
式中, E battery ( i ) E_{\text {battery }}(i) E battery ( i ) q ( i ) \mathbf{q}(i) q ( i ) p K ( i ) \mathbf{p}_{K}(i) p K ( i ) D r e m a i n ( i ) D_{remain}(i) D r e main ( i ) D K ( i ) D_{K}(i) D K ( i ) f K ( i ) f_{K}(i) f K ( i ) i = 1 i=1 i = 1 E battery ( i ) = E b E_{\text {battery }}(i)=E_b E battery ( i ) = E b D r e m a i n ( i ) = D D_{remain}(i)=D D r e main ( i ) = D
4.2 行动空间
agent根据系统当前状态和所观察的环境,选择待服务的动作包括 i 时刻被服务的UE k ′ k^{\prime} k ′ a i a_i a i
a i = ( k ( i ) , β ( i ) , v ( i ) , R k ( i ) ) a_{i}=\left(k(i), \beta(i), v(i), R_{k}(i)\right)
a i = ( k ( i ) , β ( i ) , v ( i ) , R k ( i ) )
值得注意的是,DDPG中的演员网络输出连续的动作。被 agent 选择的动作变量 UE k ( i ) ∈ [ 0 , K ] k(i)\in [0,K] k ( i ) ∈ [ 0 , K ] k ( i ) = 0 k(i)=0 k ( i ) = 0 k ′ = 1 k^{\prime}=1 k ′ = 1 k ( i ) ≠ 0 k(i)\neq 0 k ( i ) = 0 k ′ = ⌈ k ( i ) ⌉ , k^{\prime}=\lceil k(i)\rceil, k ′ = ⌈ k ( i )⌉ , ⌈ ⋅ ⌉ \lceil \cdot \rceil ⌈ ⋅ ⌉ β ( i ) ∈ [ 0 , 2 π ] \beta(i) \in[0,2 \pi] β ( i ) ∈ [ 0 , 2 π ] v ( i ) ∈ [ 0 , v max ] v(i) \in\left[0, v_{\max }\right] v ( i ) ∈ [ 0 , v m a x ] R k ( i ) ∈ [ 0 , 1 ] R_k(i) \in\left[0, 1\right] R k ( i ) ∈ [ 0 , 1 ]
4.3 奖励函数
agent 的行为是基于奖励的,选择合适的奖励函数对 DDPG 框架的性能起着至关重要的作用。我们的目标是通过最小化问题 (9) 中定义的处理延迟来实现回报最大化,如下所示:
r i = r ( s i , a i ) = − τ delay ( i ) r_{i}=r\left(s_{i}, a_{i}\right)=-\tau_{\text {delay }}(i)
r i = r ( s i , a i ) = − τ delay ( i )
其中,时间槽 i 的处理延迟为
τ delay ( i ) = ∑ k = 1 K α k ( i ) max { t local , k ( i ) , t U A V , k ( i ) + t t r , k ( i ) } \tau_{\text {delay }}(i)=\sum_{k=1}^{K} \alpha_{k}(i) \max \left\{t_{\text {local }, k}(i), t_{U A V, k}(i)+t_{t r, k}(i)\right\}
τ delay ( i ) = k = 1 ∑ K α k ( i ) max { t local , k ( i ) , t U A V , k ( i ) + t t r , k ( i ) }
,并且如果 k = k ′ k=k^{\prime} k = k ′ α k ( i ) = 1 \alpha_{k}(i)=1 α k ( i ) = 1 α k ( i ) = 0 \alpha_{k}(i)=0 α k ( i ) = 0
Q μ ( s i , a i ) = E μ [ r ( s i , a i ) + γ Q μ ( s i + 1 , μ ( s i + 1 ) ) ] Q_{\mu}\left(s_{i}, a_{i}\right)=\mathbb{E}_{\mu}\left[r\left(s_{i}, a_{i}\right)+\gamma Q_{\mu}\left(s_{i+1}, \mu\left(s_{i+1}\right)\right)\right]
Q μ ( s i , a i ) = E μ [ r ( s i , a i ) + γ Q μ ( s i + 1 , μ ( s i + 1 ) ) ]
4.4 状态标准化
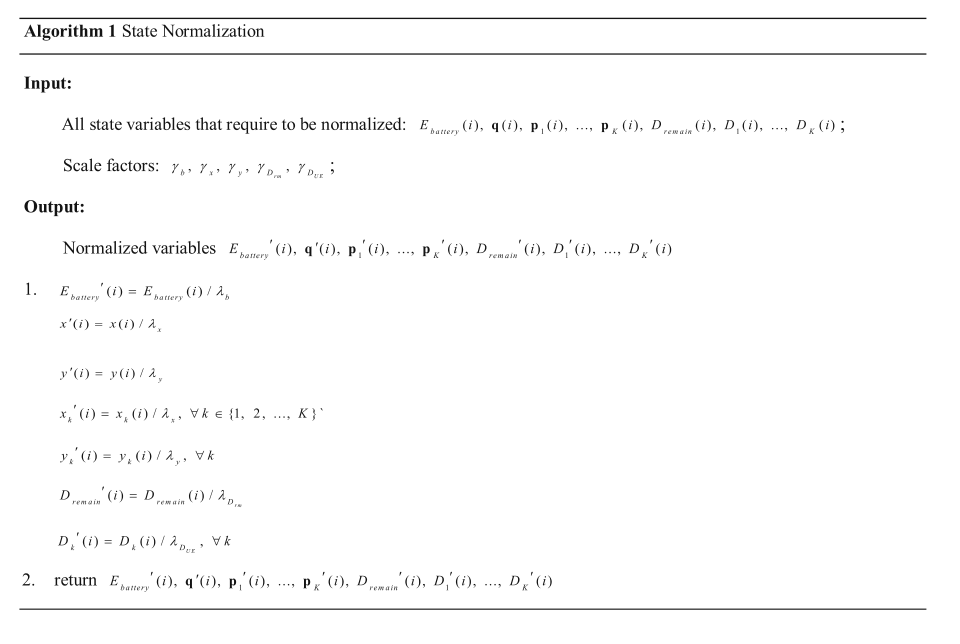
在 DNN 的训练过程中,输入在每一层的分布会随着前一层参数的变化而变化,这需要较低的学习速率和细致的参数初始化,从而减慢了训练的速度。Ioffe 和 Szegedy 提出了一种批处理归一化机制,该机制允许训练使用更高的学习率,并且对初始化不那么小心。我们提出了一种状态归一化算法对观测状态进行预处理,从而更有效地训练 DNN 。值得注意的是,与Qiu的状态归一化算法不同,本文算法将每个变量的最大值与最小值之差作为尺度因子。所提出的状态归一化算法可以很好地解决输入变量的大小差异问题。
在我们的工作中,变量 E battery ( i ) , q ( i ) , p 1 ( i ) , … , p K ( i ) , D remain ( i ) , D 1 ( i ) , … , D K − 1 ( i ) E_{\text {battery }}(i), \mathbf{q}(i), \mathbf{p}_{1}(i), \ldots, \mathbf{p}_{K}(i), D_{\text {remain }}(i), D_{1}(i), \ldots, D_{K-1}(i) E battery ( i ) , q ( i ) , p 1 ( i ) , … , p K ( i ) , D remain ( i ) , D 1 ( i ) , … , D K − 1 ( i ) D K − 1 ( i ) D_{K-1}(i) D K − 1 ( i ) γ b \gamma_b γ b γ x \gamma_x γ x γ y \gamma_y γ y γ D r m \gamma_{D_{rm}} γ D r m γ D U E \gamma_{D_{UE}} γ D U E
4.5 训练与测试
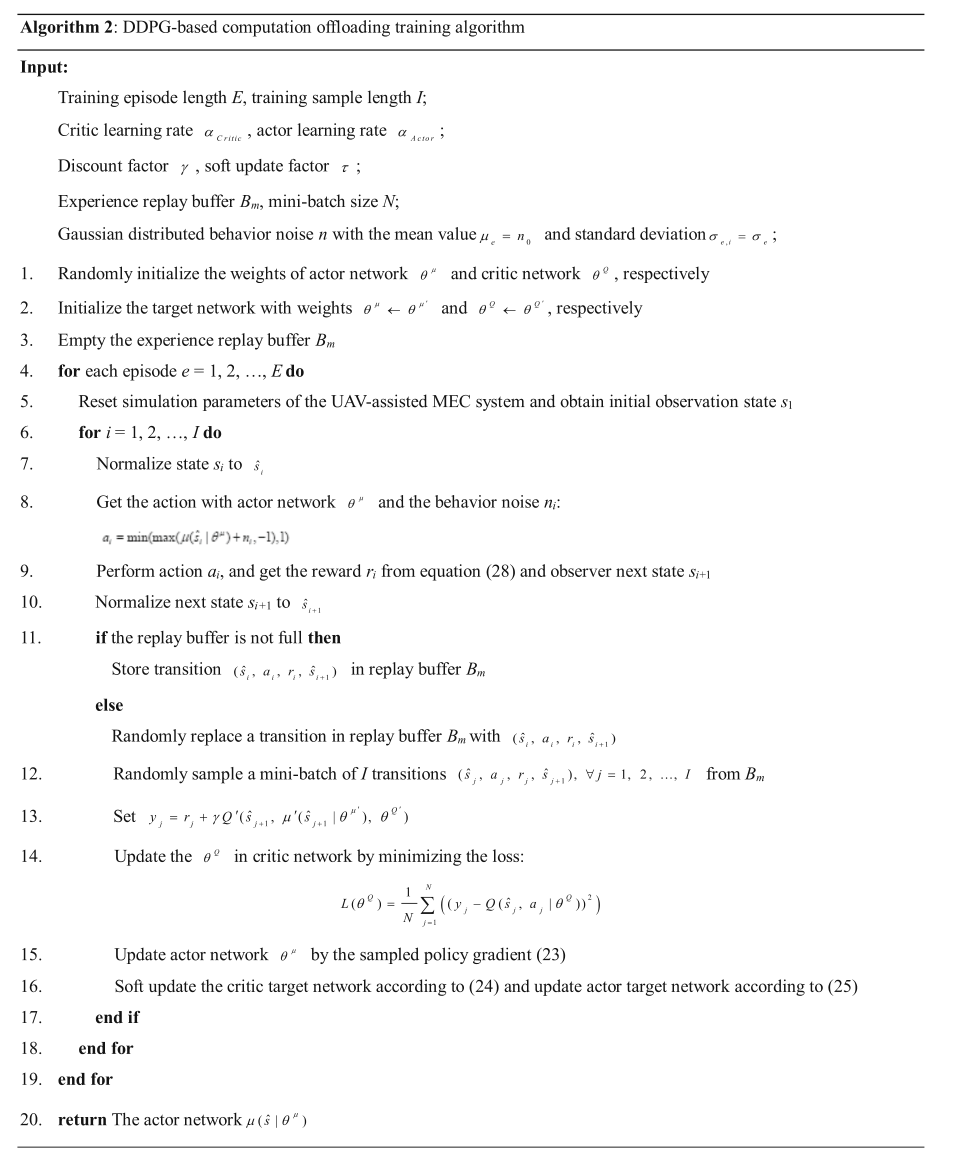
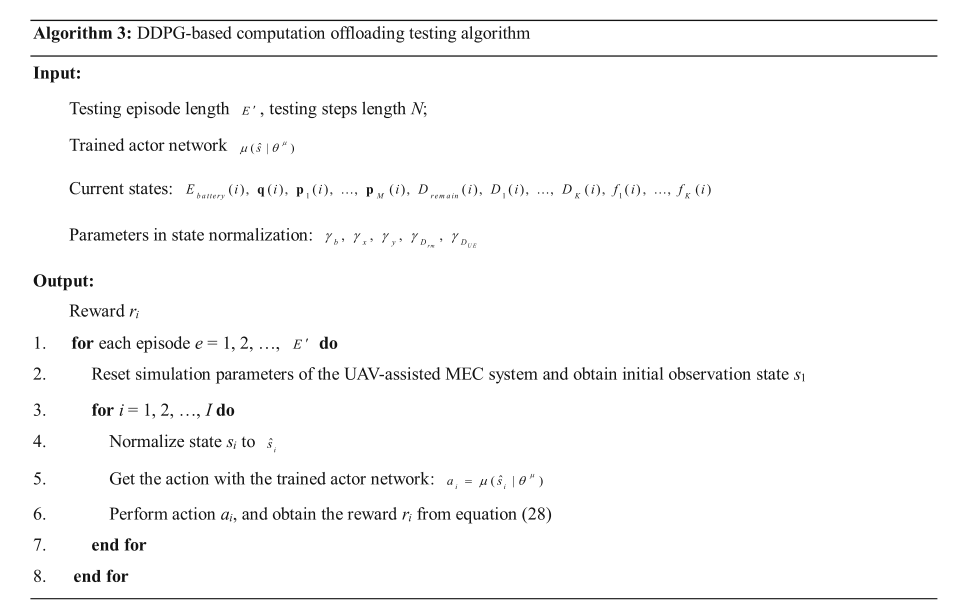
对基于 DDPG 的计算卸载算法的学习和评估分为训练和测试两个阶段。基于DDPG的计算卸载训练算法如算法 2 所示。在训练过程中,对训练行为策略的批评家网络参数和演员网络参数进行迭代更新。算法 3 描述了计算卸载测试过程,采用了算法 2 中训练好的演员网络 θ μ \theta^\mu θ μ
5 结果与分析
在本节中,我们通过数值模拟来说明提出的基于 DDPG 的无人机辅助 MEC 系统计算卸载框架。首先,介绍了仿真参数的设置。然后,对基于 DDPG 的框架在不同场景下的性能进行了验证,并与其他基线方案进行了比较。
5.1 仿真设置
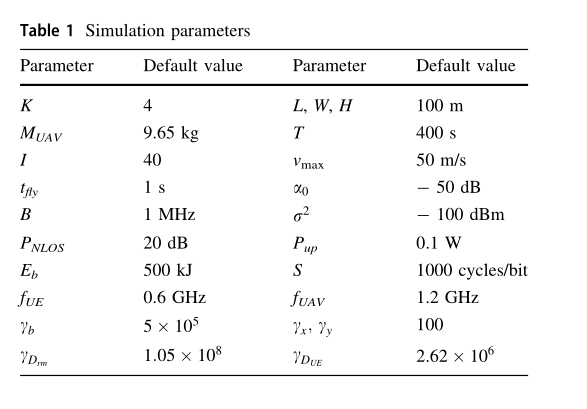
在无人机辅助的 MEC 系统中,我们考虑一个 K = 4 K=4 K = 4 L × W = 100 × 100 m 2 L\times W = 100 \times 100 m^2 L × W = 100 × 100 m 2 H = 100 m H=100 m H = 100 m M U A V = 9.65 k g M_{UAV}=9.65kg M U A V = 9.65 k g T = 400 s T=400s T = 400 s v m a x = 50 m / s v_{max}=50 m/s v ma x = 50 m / s t f l y = 1 s t_{fly}=1s t f l y = 1 s α 0 = − 50 d B \alpha_0=-50 dB α 0 = − 50 d B B = 1 M H z B=1MHz B = 1 M H z σ 2 = − 100 d B m \sigma^2=-100 dBm σ 2 = − 100 d B m f k ( i ) = 1 f_k(i)=1 f k ( i ) = 1
渗透损失为 P N L O S = 20 d B P_{NLOS}=20 dB P N L O S = 20 d B P u p = 0.1 W P_{up}=0.1 W P u p = 0.1 W E b = 500 k J E_b=500 kJ E b = 500 k J f U E = 0.6 G H z f _{UE}=0.6 GHz f U E = 0.6 G H z f U A V = 1.2 G H z f_{UAV}=1.2 GHz f U A V = 1.2 G H z γ b = 5 × 10 5 , γ x = 100 , γ y = 100 , γ D r m = 1.05 × 10 8 , γ D U E = 2.62 × 10 6 \gamma_{b}=5 \times 10^{5}, \gamma_{x}=100, \gamma_{y}=100, \gamma_{D_{rm}}=1.05 \times 10^{8}, \gamma_{D_{UE}}=2.62 \times 10^{6} γ b = 5 × 1 0 5 , γ x = 100 , γ y = 100 , γ D r m = 1.05 × 1 0 8 , γ D U E = 2.62 × 1 0 6
为作比较,现将四种基线方法说明如下:
将所有任务卸载到无人机(仅卸载):在每个时间段,无人机将在区域中心的固定位置向终端提供计算服务。UE 将所有的计算任务都交给无人机上的 MEC 服务器处理。
全本地执行(Local-only):在不借助无人机的情况下,终端的所有计算任务都在本地执行。
基于Actor Critical 的计算卸载算法 (AC):为了评价本文提出的基于 DDPG 的计算卸载算法的性能,在计算卸载问题上还实现了基于连续动作空间的 RL 算法 AC 。为了与 DDPG 进行比较, AC 还采用了状态归一化。
基于DQN的计算卸载算法(DQN):将传统的基于离散动作空间的 DQN 算法与提出的基于 DDPG 的算法进行比较。在无人机飞行过程中,角度水平被定义为 B = { 0 , π / 5 , … , 2 π } \mathcal{B}=\{0, \pi / 5, \ldots, 2 \pi\} B = { 0 , π /5 , … , 2 π } V = { 0 , v m a x / 10 , … , v m a x } \mathcal{V}=\{0, v_{max}/ 10, \ldots, v_{max}\} V = { 0 , v ma x /10 , … , v ma x } O = { 0 , 0.1 , … , 1.0 } \mathcal{O}=\{0, 0.1, \ldots, 1.0\} O = { 0 , 0.1 , … , 1.0 }
5.2 仿真结果与讨论
5.2.1 参数分析
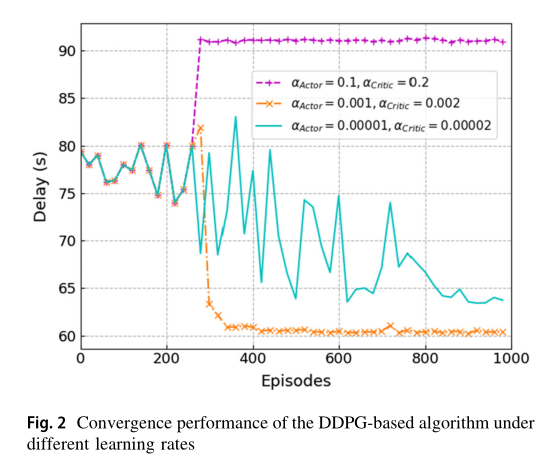
我们首先进行了一系列的实验,以确定最优值的重要超参数用于算法比较。本文算法在不同学习速率下的收敛性能如图 2 所示。我们假设评论网络和演员网络的学习速度是不同的。首先,我们可以清楚地看到,当 α Actor = 0.1 , α Critic = 0.2 \alpha_{\text {Actor }}=0.1, \alpha_{\text {Critic }}=0.2 α Actor = 0.1 , α Critic = 0.2 α Actor = 0.001 , α Critic = 0.002 \alpha_{\text {Actor }}=0.001, \alpha_{\text {Critic }}=0.002 α Actor = 0.001 , α Critic = 0.002 α Actor = 0.1 , α Critic = 0.2 \alpha_{\text {Actor }}=0.1, \alpha_{\text {Critic }}=0.2 α Actor = 0.1 , α Critic = 0.2 α Actor = 0.00001 , α Critic = 0.00002 \alpha_{\text {Actor }}=0.00001, \alpha_{\text {Critic }}=0.00002 α Actor = 0.00001 , α Critic = 0.00002 α Actor = 0.001 , α Critic = 0.002 \alpha_{\text {Actor }}=0.001, \alpha_{\text {Critic }}=0.002 α Actor = 0.001 , α Critic = 0.002
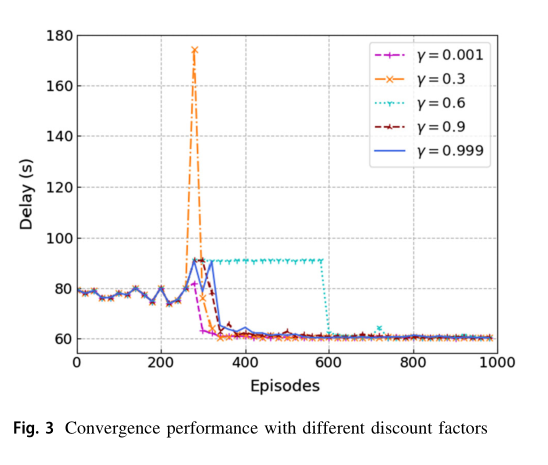
在图 3 中,我们比较了不同折扣因子 γ \gamma γ γ = 0.001 \gamma=0.001 γ = 0.001 γ \gamma γ γ \gamma γ γ \gamma γ
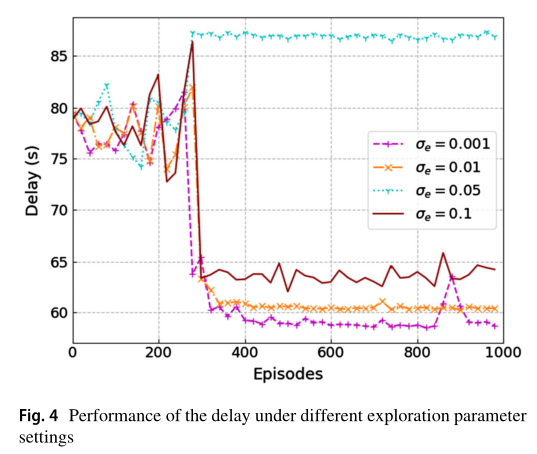
图 4 显示了在不同探测参数 σ e \sigma_e σ e σ e = 0.1 \sigma_e=0.1 σ e = 0.1 σ e \sigma_e σ e σ e = 0.001 \sigma_e= 0.001 σ e = 0.001 σ e \sigma_e σ e σ e = 0.01 \sigma_e=0.01 σ e = 0.01
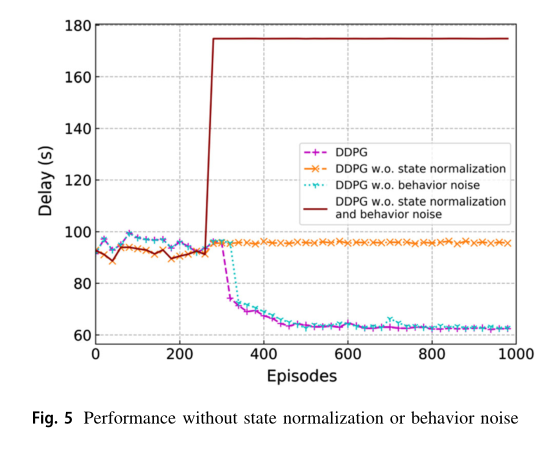
图 5 显示了不使用状态归一化和行为噪声的训练策略对 DDPG 训练算法的影响。一方面,如果在没有行为噪声的情况下训练 DDPG 算法,算法的收敛速度会变慢。另一方面,如果不进行状态归一化训练,即在状态归一化中不引入尺度因子,训练算法将失效。这是因为在没有状态归一化策略的情况下,E battery ( i ) E_{\text {battery }}(i) E battery ( i ) D remain ( i ) D_{\text {remain }}(i) D remain ( i ) D k ( i ) D_{k}(i) D k ( i )
5.2.2 性能比较
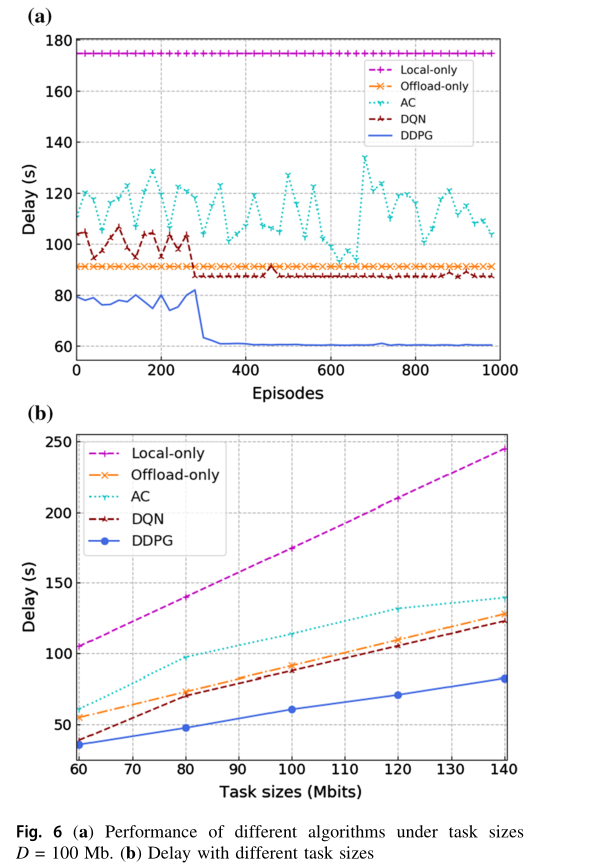
图 6 显示了不同算法之间的性能比较。在图 6a 中,我们对 RL算法的 DNNs 进行了总计1000次迭代的训练。从图中可以看出,随着迭代次数的增加, AC 算法不能收敛,而 DQN 和 DDPG 算法都可以收敛。这是因为 AC 算法存在着行动者网络和批评网络同时更新的问题。行动者网络的行为选择依赖于评论网络的价值功能,但评论网络本身难以收敛。因此,AC算法在某些情况下可能不收敛。相比之下, DQN 和 DDPG均受益于评价网络和目标网络的双网络结构,可用于切断训练数据之间的相关性,从而找到最优的行动策略。利用算法收敛后的延迟结果,比较不同任务大小设置下的算法,结果如图 6b 所示。在图 6b 中,对于相同的任务大小, DDPG 算法的时延在五种算法中始终是最低的。由于探索了离散的动作空间和可用动作之间的不可忽略空间, DQN 无法准确地找到最优卸载策略。而 DDPG 算法则探索一个连续的动作空间,并采取一个精确的动作,最终获得最优策略,显著减少了延迟。此外, DQN 算法的收敛速度远高于 DDPG 算法。 Offload-only 和 Local-only 两种算法不能充分利用整个系统的计算资源。因此,对于相同的任务大小, DDPG 算法的处理延迟明显低于 Offload-only 和 Local-only 算法。此外,随着任务大小的增大, DDPG 算法优化后的处理延迟增加速度明显慢于 Offload-only 和 Local-only 算法,表明了该算法的优势。
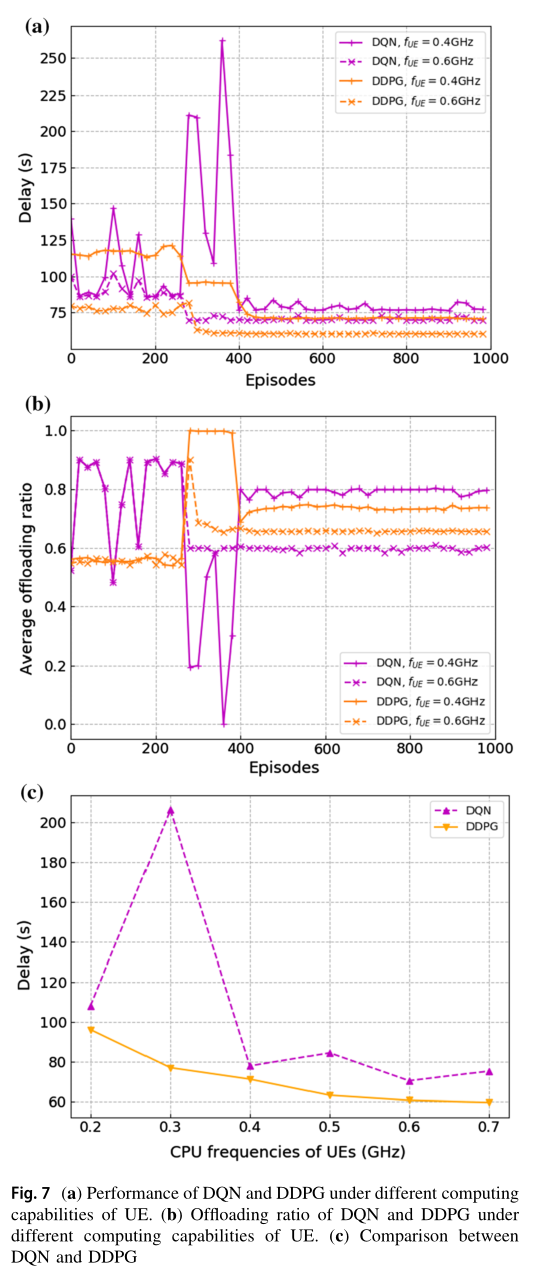
图 7a 和图 b 显示了同一组实验在延迟和卸载比方面的性能。图 7a 显示了不同 UE 计算能力下 DQN 方案和 DDPG 方案的收敛性能。本文提出的方案之所以没有与 AC 方案进行比较,是因为 AC 方案仍然不收敛。我们可以发现,当 UE 的计算能力较小时,即 f U E = 0.4 G H z f_{UE}=0.4 GHz f U E = 0.4 G H z
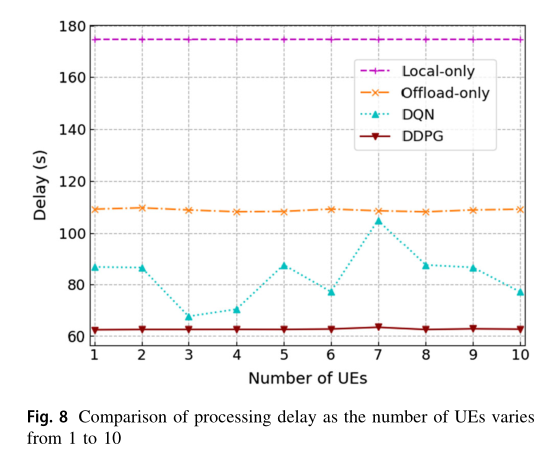
在图 8 中,我们比较了UE 的数量在1到10之间变化下 DDPG 方案、 DQN 、 Offload-only 和 Local-only 的平均处理延迟 。我们假设在不同数量的终端下,一个时间段内要完成的总任务大小是相同的。如图 8 所示,随着 UE 数量的增加,除 DQN 外,其他方案的平均处理延迟几乎不变。随着 UE 数量的增加, DQN 方案的处理延迟在 86 s左右波动。原因可以解释如下。不同数量 UE 的情况下, DQN 输出动作取值范围差异较大。因此,当样本作为 DQN 训练的输入时, DQN 可能倾向于输出更大的值。 DDPG 的演员网络输出多维动作,保证了 DNN 的输入数据在同一范围内,即 [0,1] ,保证了 DDPG 算法的收敛性和稳定性。此外,所提出的 DDPG 方案具有最小的延迟。这是因为 DDPG 方案能够在连续动作中找到最优值,从而得到最优控制策略。
6 结论
本文研究了无人机辅助的移动通信系统中的计算卸载问题,该系统由飞行无人机为终端提供通信和计算服务。通过联合优化用户调度、任务卸载率、无人机飞行角度和飞行速度,以最小化整个时间段内最大处理延迟之和为目标。为了解决离散变量非凸优化问题,引入了 DDPG 训练算法来获得最优卸载策略。我们描述了 RL 相关的背景知识和 DDPG 训练过程。然后,提出状态归一化算法,使 DDPG 算法更容易收敛。通过仿真分析了 DDPG 算法的参数,比较了不同参数的影响,包括学习率、折扣因子和训练策略。仿真结果表明,与基线算法相比,我们提出的算法在处理延迟方面有更好的性能。在未来的工作中,我们将研究我们的算法与其他流行的RL算法的性能,如 ACER , ACKTR , PRO2 和 TRPO 。