Python中Pandas的DataFrame对象的行以及列的增删改查
参考链接:
https://www.cnblogs.com/datasnail/p/9675410.html
https://blog.csdn.net/qq_40981268/article/details/86498672
https://www.cnblogs.com/guxh/p/9420610.html
https://www.cnblogs.com/zmc940317/p/13608237.html
https://www.cnblogs.com/datasnail/p/9757081.html
https://github.com/dataSnail/blogCode/tree/master/python_curd
pandas DaFrame的创建方法
在pandas里,DataFrame是最经常用的数据结构,这里总结生成和添加数据的方法:
①把其他格式的数据整理到DataFrame中;
②在已有的DataFrame中插入N列或者N行。
1. 字典类型读取到DataFrame(dict to DataFrame)
假如我们在做实验的时候得到的数据是dict类型,为了方便之后的数据统计和计算,我们想把它转换为DataFrame,存在很多写法,这里简单介绍常用的几种:
**方法一:**直接使用pd.DataFrame(data=test_dict)即可,括号中的data=写不写都可以,具体如下:
test_dict = {'id':[1,2,3,4,5,6],'name':['Alice','Bob','Cindy','Eric','Helen','Grace '],'math':[90,89,99,78,97,93],'english':[89,94,80,94,94,90]}
#[1].直接写入参数test_dict
test_dict_df = pd.DataFrame(test_dict)
#[2].字典型赋值
test_dict_df = pd.DataFrame(data=test_dict)
那么,我们就得到了一个DataFrame,如下:
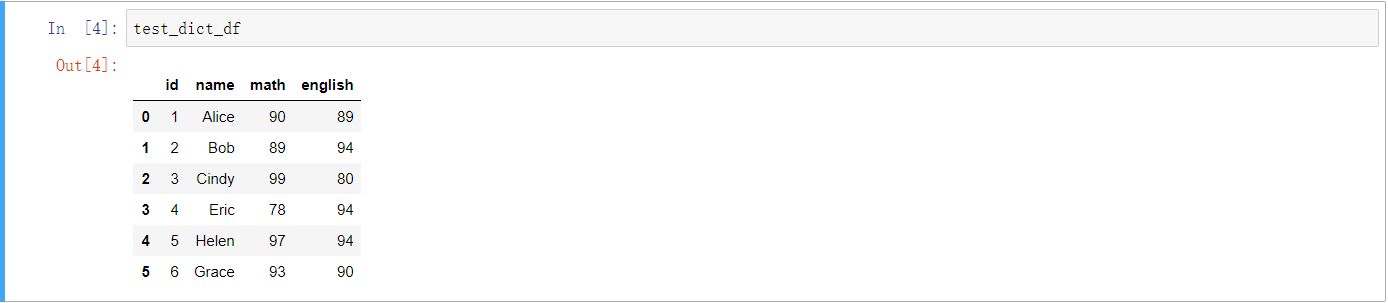
应该就是这个样子了。
**方法二:**使用from_dict方法:
test_dict_df = pd.DataFrame.from_dict(test_dict)结果是一样的,不再重复贴图。
**其他方法:**如果你的dict变量很小,例如{'id':1,'name':'Alice'},你想直接写到括号里:
test_dict_df = pd.DataFrame({'id':1,'name':'Alice'}) # wrong style这样是不行的,会报错ValueError: If using all scalar values, you must pass an index,是因为如果你提供的是一个标量,必须还得提供一个索引Index,所以你可以这么写:
test_dict_df = pd.DataFrame({'id':1,'name':'Alice'},pd.Index(range(1)))后面的可以写多个pd.Index(range(3),就会生成三行一样的,是因为前面的dict型变量只有一组值,如果有多个,后面的Index必须跟前面的数据组数一致,否则会报错:
pd.DataFrame({'id':[1,2],'name':['Alice','Bob']},pd.Index(range(2))) #must be 2 in range function.关于选择列,有些时候我们只需要选择dict中部分的键当做DataFrame的列,那么我们可以使用columns参数,例如我们只选择’id’,'name’列:
test_dict_df = pd.DataFrame(data=test_dict,columns=['id','name']) #only choose 'id' and 'name' columns这里就不在多写了,后续变更颜色添加内容。
2. csv文件构建DataFrame(csv to DataFrame)
我们实验的时候数据一般比较大,而csv文件是文本格式的数据,占用更少的存储,所以一般数据来源是csv文件,从csv文件中如何构建DataFrame呢? txt文件一般也能用这种方法。
方法一:最常用的应该就是pd.read_csv('filename.csv')了,用 sep指定数据的分割方式,默认的是','
df = pd.read_csv('./xxx.csv')如果csv中没有表头,就要加入head参数
pandas DataFrame的查询方法
在操作DataFrame时,肯定会经常用到loc,iloc,at等函数,各个函数看起来差不多,但是还是有很多区别的,我们一起来看下吧。
首先,还是列出一个我们用的DataFrame,注意index一列,如下:
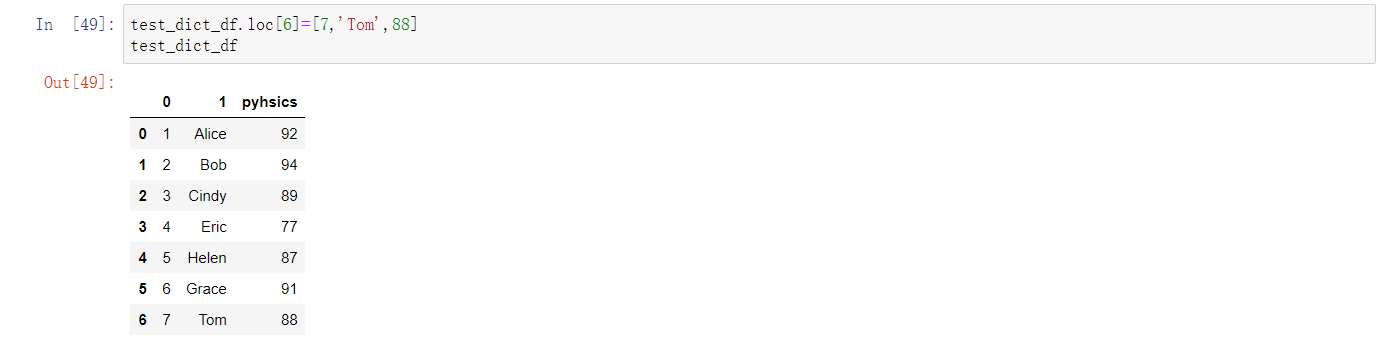
接下来,介绍下各个函数的用法:
1、loc函数
愿意看官方文档的,请戳这里,这里一般最权威。
loc函数是基于“标签”选择数据的,但是也可以接受一个boolean的array,对于每个用法,我们从参数方面来一一举例:
1.1 单个label
接受一个“标签”(label)参数,返回一个Series,例如下面这个例子收一个标签,返回通过这个标签定位的行的值,注意这里是通过标签定位,而不是通过中括号中的数字定位第几行,之后我们通过对比iloc函数时还会细说。
test_dict_df.loc[1] #return the row with name 'Bob'
test_dict_df.loc[7] #return the row with name 'Time' important!!!
# type(test_dict_df.loc[1]) #pandas.core.series.Series
1.2 一个label的array
如果键入一个标签的array,那么就返回一个对应的DataFrame:
test_dict_df.loc[[1,2,4]]结果如下:
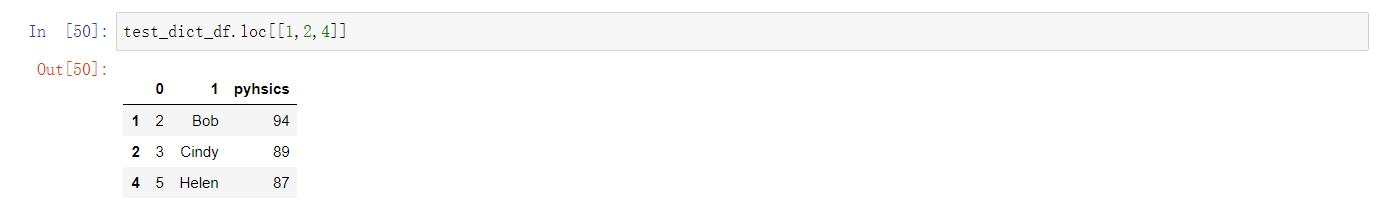
1.3 加入一个切片array
test_dict_df.loc[1:4]结果如下:
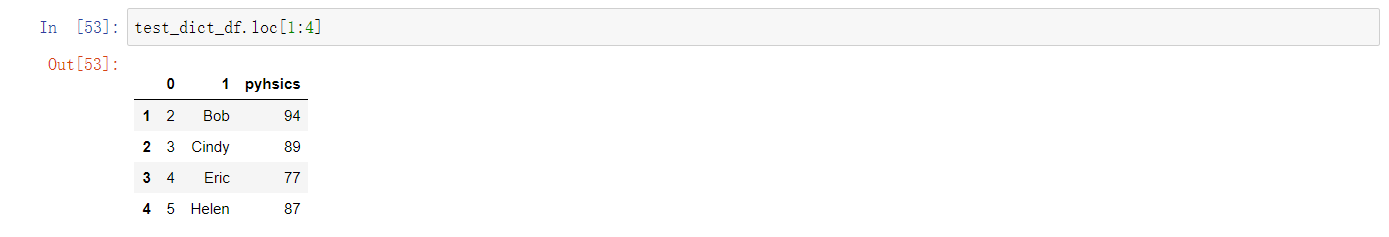
1.4 行标签,列标签
通过在中括号中加入行标签和列标签来定位一个cell(单元格),相当于坐标的定位:
test_dict_df.loc[1,'pyhsics'] #result:941.5 行标签或者列标签是切片array
test_dict_df.loc[1:4,'pyhsics']
# test_dict_df.loc[1:4,'pyhsics':'math']
1.6 还可以接受条件,进行选择
例如我们选择英语成绩超过90的所有行:
test_dict_df.loc[test_dict_df['pyhsics']>90]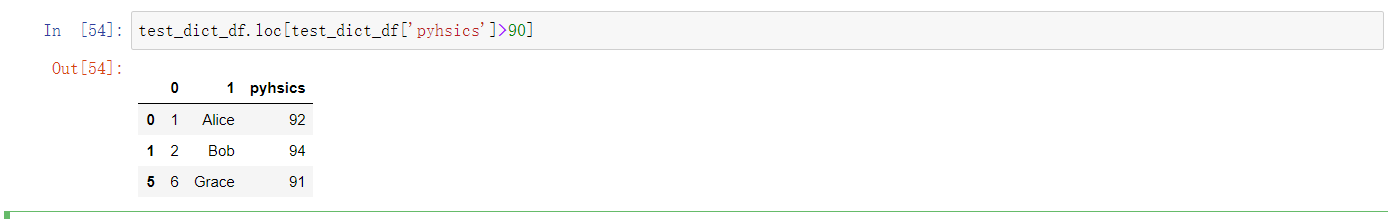
当然,也可以再条件选择后,再加入列选择,列选择的时候可以单列,也可以是切片数组,通过上面的介绍这里就可以灵活处理:
test_dict_df.loc[test_dict_df['pyhsics']>90,'pyhsics'] #single label
test_dict_df.loc[test_dict_df['pyhsics']>90,'pyhsics':'name'] #slice array
test_dict_df.loc[test_dict_df['pyhsics']>90,['pyhsics','name']] #label array
1.7 接受一个boolean的array
可以接受一个boolean的array,相当于按照这个表的真假按照位置的顺序选择值
test_dict_df.loc[[True,False,False,True]]loc还有很多用法,这里先介绍到这里吧,当然如果你的DataFrame是复合的行或者复合列,写法也是不同的,具体就可以查阅官方文档了!
2、iloc函数
官方文档戳这里。
iloc函数与loc函数不同的是,它接受的是一个数字,代表着要选择数据的位置:
test_dict_df.iloc[6]这代表我们选择的是第6行,而不是index为6的那一行。当然,也可以接受一个boolean的array,相当于按照这个表的真假按照位置的顺序选择值:
test_dict_df.iloc[[True,False,False,True]]这里iloc也可以接受切片array:
# test_dict_df.iloc[1:2]
test_dict_df.iloc[[1,2,4]]
3、ix函数(0.20.0版本后已经弃用)
ix就是一种混合索引,字符串的标签和证书的数据索引都可以作为合法输入,其实相当于loc和iloc的一个混合方法:
test_dict_df.ix['Alice']
test_dict_df.ix[1]
上述两种方法都能得到值,这里我们就不追究这个函数具体是怎样的检索顺序或者工作原理了。因为官方给出的是从pandas0.20.0之后,ix函数已经被弃用。其实在使用的时候,ix函数虽然方便,但是的确有时候会显得比较混乱,所以我们之后也尽量少用这个函数吧,还是按照官方大佬的指导。
4、at函数
at是用来选择单个值的,此时用法类似于loc:
test_dict_df.at[1,'english']
test_dict_df.loc[1,'english']
以上两种方法都能选择到,label为1,列为’english’的那个值,但是据说at速度要快,这点我没有考证过。
5、iat函数
iat函数相对于at函数,就相当于iloc相对于loc函数。iat也只能选择一个值。只不过是用索引位置来选择,注意:行列都是索引位置来选择,从0开始数。
# test_dict_df.iat[1,'english'] #error!!!
test_dict_df.iat[2,2] #right!!!
6、概括一下
最后我们概括一下:
1、 loc和iloc函数都是用来选择某行的,iloc与loc的不同是:iloc是按照行索引所在的位置来选取数据,参数只能是整数。而loc是按照索引名称来选取数据,参数类型依索引类型而定;
2、 at和iat函数是只能选择某个位置的值,iat是按照行索引和列索引的位置来选取数据的。而at是按照行索引和列索引来选取数据;
3、 loc和iloc函数的功能包含at和iat函数的功能。
pandas DataFrame行或列的删除方法
平时在用DataFrame时候,删除操作用的不太多,基本是从源DataFrame中筛选数据,组成一个新的DataFrame再继续操作。
1. 删除DataFrame某一列
2.1,del
del df['A'] # 删除A列,会就地修改2.2,drop
我们使用drop()函数,此函数有一个列表形参labels,写的时候可以加上labels=[xxx],也可以不加,列表内罗列要删除行或者列的名称,默认是行名称,如果要删除列,则要增加参数axis=1,操作如下:
df = df.drop(['B', 'C'], axis=1)               # drop不会就地修改,创建副本返回
df.drop(['B', 'C'], axis=1, inplace=True) # inplace=True会就地修改这里注意输出的结果是执行此方法的结果,而不是输出test_dict_df的结果,是因为方法默认的并不是在本身执行操作,这时候输出test_dict_df输出的仍然是没有进行删除操作的原DataFrame,如果你想在原DataFrame上进行操作,需要加上inplace=True,等价于在操作完再赋值给本身。
使用列数删除,传入参数是int,列表,者切片:
df.drop(df.columns[0], axis=1, inplace=True)       # 删除第1列
df.drop(df.columns[0:3], axis=1, inplace=True)     # 删除前3列
df.drop(df.columns[[0, 2]], axis=1, inplace=True)  # 删除第1第3列
2.3,通过各种筛选方法实现删除列
请注意一定要传入索引。
2.4,删除/选取某列含有特殊数值的行
import pandas as pd
import numpy as np

a=np.array([[1,2,3],[4,5,6],[7,8,9]])
df1=pd.DataFrame(a,index=['row0','row1','row2'],columns=list('ABC'))
print(df1)
df2=df1.copy()

#删除/选取某列含有特定数值的行
#df1=df1[df1['A'].isin([1])]
#df1[df1['A'].isin([1])]  选取df1中A列包含数字1的行

df1=df1[~df1['A'].isin([1])]
#通过~取反,选取不包含数字1的行
print(df1)
2. 删除DataFrame某一行
2.1,drop
通过行名称删除:
df = df.drop(['1', '2'])           # 不指定axis默认为0
df.drop(['1', '3'], inplace=True)
删除某一行,在上面删除列操作的时候也稍有提及,如果不加axis=1,则默认按照行号进行删除,例如要删除第0行和第4行:
df.drop(df.index[0], inplace=True)       # 删除第1行
df.drop(df.index[0:3], inplace=True)     # 删除前3行
df.drop(df.index[[0, 2]], inplace=True)  # 删除第1第3行
df.drop([0,4])
同理,你要在源DataFrame上进行操作就得加上inplace参数,否则不会在test_dict_df上改动。
当然,如果你的DataFrame有很多级,你可以加上level参数,这里就不多赘述了。
2.2,通过各种筛选方法实现删除行
详见pandas“选择行单元格,选择行列“的笔记
举例,通过筛选可以实现很多功能,例如要对某行数据去重,可以获取去重后的index列表后,使用loc方法:
>>> df.loc['2','B']=9
>>> df
    A   B   C   D
1   0   1   2   3
2   4   9   6   7
3   8   9  10  11
4  12  13  14  15
>>> chooses = df['B'].drop_duplicates().index #必须执行index来获取索引
>>> df.loc[chooses]
    A   B   C   D
1   0   1   2   3
2   4   9   6   7
4  12  13  14  15
2.3,删除/选取某行含有特殊数值的列
#删除/选取某行含有特定数值的列
cols=[x for i,x in enumerate(df2.columns) if df2.iat[0,i]==3]
#利用enumerate对row0进行遍历,将含有数字3的列放入cols中
print(cols)

#df2=df2[cols]   选取含有特定数值的列
df2=df2.drop(cols,axis=1) #利用drop方法将含有特定数值的列删除
print(df2)
3.删除含有空值的行或列
实现思路:利用pandas.DateFrame.fillna对空值赋予特定值,再利用上文介绍的方法找到这些含有特定值的行或列去除即可。
import pandas as pd
import numpy as np

df1 = pd.DataFrame(
    [
        [np.nan, 2, np.nan, 0],
        [3, 4, np.nan, 1],
        [np.nan, np.nan, np.nan, 5],
        [np.nan, 3, np.nan, 4]
    ],columns=list('ABCD'))
print(df1)
df2=df1.copy()

df1['A']=df1['A'].fillna('null') #将df中A列所有空值赋值为'null'
print(df1)
df1=df1[~df1['A'].isin(['null'])]
print(df1)

#删除某行空值所在列
df2[0:1]=df2[0:1].fillna('null')
print(df2)
cols=[x for i,x in enumerate(df2.columns) if df2.iat[0,i]=='null']
print(cols)
df2=df2.drop(cols,axis=1)
print(df2)
4添加列
一般涉及到增加列项时,经常会对现有的数据进行遍历运算,获得新增列项的值,所以这里结合对DataFrame的遍历讨论增加列。
例如,想增加一列’E’,值等于’A’和’C’列对应值之和。
4.1,遍历DataFrame获取序列的方法
s = [a + c for a, c in zip(df['A'], df['C'])]          # 通过遍历获取序列
s = [row['A'] + row['C'] for i, row in df.iterrows()]  # 通过iterrows()获取序列,s为list
s = df.apply(lambda row: row['A'] + row['C'], axis=1)  # 通过apply获取序列,s为Series
s = df['A'] + df['C']                                  # 通过Series矢量相加获取序列
s = df['A'].values + df['C'].values                    # 通过Numpy矢量相加获取序列
4.2,[ ],loc
通过df[]或者df.loc添加序列
df.loc[:, 'E'] = s
df['E'] = s
4.3,Insert
可以指定插入位置,和插入列名称
df.insert(0, 'E', s) 此时,就得到了添加好的DataFrame,需要注意的是DataFrame默认不允许添加重复的列,但是在insert函数中有参数allow_duplicates=True,设置为True后,就可以添加重复的列了,列名也是重复的。
4.4,concat
s = pd.Series([16, 17, 18, 19], name='E', index=df.index)
df = pd.concat([df, s], axis=1)
4.5,iloc和loc遍历过程中给列赋值
效率比较低
df[‘E’]是DataFrame的一个Series,是引用,对其修改也能改变DataFrame,但运行时报了Warning
df['E'] = None  # 需事先创建e列,否则iloc遍历会报错,loc遍历无需事先创建
for i in range(len(df)):
    df['E'].iloc[i] = df['A'].iloc[i] + df['C'].iloc[i]
# SettingWithCopyWarning: A value is trying to be set on a copy of a slice from a DataFrame
不用Series不会报Warning:
df['E'] = None
col_no = [i for i in df.columns].index('E')
for i in range(len(df)):
    df.iloc[i, col_no] = df['A'].iloc[i] + df['C'].iloc[i]
用loc无需先给E列赋空值:
for i in df.index:
    df.loc[i, 'E'] = df.loc[i, 'A'] + df.loc[i, 'C']
4.6,逐列增加
简单的逐列添加内容,可以:
df[len(df)] = [16, 17, 18, 19]但需要注意:len(df)生成的是int,如果生成的int,df已经存在了,会覆盖该列数据,而不会新增
4.7,其他方法
增加3列,EFG,value默认为np.NaN
df = pd.concat([df, pd.DataFrame(columns=list('EFG'))])   # 列的次序无法指定,并且fillna时会对整个df做出调整
df = df.reindex(columns=list('ABCDEFG'),  fill_value=0)   # 列的次序按照list指定,并且fill_value只对新增列做出调整,推荐!
5 添加行
5.1,loc,at,set_value
想增加一行,行名称为‘5’,内容为[16, 17, 18, 19]
df.loc['5'] = [16, 17, 18, 19]    # 后面的序列是Iterable就行
df.at['5'] = [16, 17, 18, 19]
df.set_value('5', df.columns, [16, 17, 18, 19], takeable=False)    # warning,set_value会被取消
5.2,append
添加有name的Series:
s = pd.Series([16, 17, 18, 19], index=df.columns, name='5')
df = df.append(s)
添加没有name的Series,必须ignore_index:
s = pd.Series([16, 17, 18, 19], index=df.columns)
df = df.append(s, ignore_index=True)
可以 append字典列表,同样需要必须ignore_index:
ls = [{'A': 16, 'B': 17, 'C': 18, 'D': 19}, {'A': 20, 'B': 21, 'C': 22, 'D': 23}]
df = df.append(ls, ignore_index=True)
5.3,逐行增加
简单的逐行添加内容,可以:
df.loc[len(df)] = [16, 17, 18, 19]但需要注意:len(df)生成的是int,如果生成的int,df已经存在了,会覆盖该行数据,而不会新增
5.4,插入行
增加行没找到类似insert这种可以插入的方法,暂时替代方法可以先reindex,再赋值:
df = df.reindex(index=df.index.insert(2, '5'))
df.loc['5'] = [16, 17, 18, 19]
pandas DataFrame的修改方法
对于DataFrame的修改操作其实有很多,不单单是某个部分的值的修改,还有一些索引的修改、列名的修改,类型修改等等。我们仅选取部分进行介绍。
一、值的修改
DataFrame的修改方法,其实前面介绍loc方法的时候介绍了一些。
1、 loc方法修改
loc方法实际上是定位某个位置的数据的,但是定位完以后就可以对此位置的数据进行修改,使用此方法可以对DataFrame进行的修改如下:
- 对某行、某N行进行修改;
- 对某列、某N列进行修改;
- 对横坐标为某行或某N行,纵坐标为某列或者某N列的数据进行修改;
可以看出基本用loc方法我们对DataFrame可以进行任意修改了。
1.1 对某行、某N行进行修改
# 对第1行进行修改
test_dict_df.loc[1:1,('english','id','math','name')]=[90,2,100,'Alice_m']
# 对第0行到第1行进行修改
test_dict_df.loc[0:1,('english','id','math','name')]=[[90,1,100,'Alice_m'],[70,2,100,'Bob']]
# 对第0行和第2行进行修改
test_dict_df.loc[0:3:2,('english','id','math','name')]=[[90,1,100,'Alice_m'],[70,2,100,'Bob']]
可以看出具体的方法就是用loc方法,对某行或者某N行进行定位,然后赋予合适的格式的值就可以了。
1.2 对某列、某N列进行修改
学会了使用loc方法对行的修改,那触类旁通,对列的修改也很简单了。对列修改也就是修改此列的所有行。
# 对第english列进行修改
test_dict_df.loc[:,('english')]=[90,80,70,90,90,59] #test_dict_df.loc[:,'english']=[90,80,70,90,90,59]
# 对第english列和id列进行修改,注意赋值的写法
test_dict_df.loc[:,('english','id')]=[[90,1],[80,2],[80,2],[80,2],[80,2],[80,2]]
1.3 对某个区域的值进行修改
# 对第1、2行的english列和 id列进行修改
test_dict_df.loc[1:2,('english','id')]=[[38,2],[23,2]]
1.4 总结
可以看到loc方法就是,只要你能选到某个或者某个区域的值,然后就可以对此部分的值进行修改。但是要注意赋值部分的组织方式。
2、 iloc、at、iat方法修改
类比于上面的方式,其实只要能选择,都是可以修改的。选择方法可以看pandas DataFrame的查询(选择)篇。
二、列名的修改
1、直接全部更改
这种方法是对DataFrame的列名进行重新赋值,比较暴力直接。
test_dict_df.columns=['english_new','id_new','math_new','name_new']2、使用rename方法
这种方法是比较推荐的,通过rename方法,注意参数inplace=True的时候,才能真正的在原来的DataFrame上进行修改。
test_dict_df.rename(columns={'english_new':'english'},inplace=True)三、索引的修改
1、修改索引名称
上面的rename方法,如果不写columns=xx就默认修改索引了 。
test_dict_df.rename({0:'english1'},inplace=True)2、重置索引
通过reset_index()方法我们可以重置索引,drop参数为True时,直接丢弃原来的索引,否则原来的索引新生成一列名为’index’的列:
test_dict_df.reset_index(inplace=True,drop=True)2、设置其他列为索引
当然我们也可以用其他列为索引,通过set_index()方法:
test_dict_df.set_index('id_new')四、总结
可以看到,所谓的修改首先要能选择修改的位置,即定位,然后对确定好的位置进行重新赋值,所以我们学会了如何选择数据,也就基本能修改此处的数据。
dataframe的拼接与合并
1、merge
pd.merge(left, right, how='inner', on=None, left_on=None, right_on=None,
         left_index=False, right_index=False, sort=True,
         suffixes=('_x', '_y'), copy=True, indicator=False)
left︰ 对象
right︰ 另一个对象
on︰ 要加入的列 (名称)。必须在左、 右综合对象中找到。如果不能通过 left_index 和 right_index 是假,将推断 DataFrames 中的列的交叉点为连接键
left_on︰ 从左边的综合使用作为键列。可以是列名或数组的长度等于长度综合
right_on︰ 从正确的综合,以用作键列。可以是列名或数组的长度等于长度综合
left_index︰ 如果为 True,则使用索引 (行标签) 从左综合作为其联接键。在与多重 (层次) 的综合,级别数必须匹配联接键从右综合的数目
right_index︰ 相同用法作为正确综合 left_index
how︰ 之一 ‘左’,‘右’,‘外在’、 ‘内部’。默认为内部。每个方法的更详细说明请参阅︰
sort︰ 综合通过联接键按字典顺序对结果进行排序。默认值为 True,设置为 False将提高性能极大地在许多情况下
suffixes︰ 字符串后缀并不适用于重叠列的元组。默认值为 (‘_x’,‘_y’)。
copy︰ 即使重新索引是不必要总是从传递的综合对象,复制的数据 (默认值True)。在许多情况下不能避免,但可能会提高性能 / 内存使用情况。可以避免复制上述案件有些病理但尽管如此提供此选项。
indicator︰ 将列添加到输出综合呼吁 _merge 与信息源的每一行。_merge 是绝对类型,并对观测其合并键只出现在 ‘左’ 的综合,观测其合并键只会出现在 ‘正确’ 的综合,和两个如果观察合并关键发现在两个 right_only left_only 的值。
result = pd.merge(left, right, on='key')
result = pd.merge(left, right, on=['key1', 'key2'])
result = pd.merge(left, right, how='left', on=['key1', 'key2'])
result = pd.merge(left, right, how='right', on=['key1', 'key2'])
result = pd.merge(left, right, how='outer', on=['key1', 'key2'])
2、append
result = df1.append(df2)
result = df1.append(df4)
result = df1.append([df2, df3])
result = df1.append(df4, ignore_index=True)
3、join
left.join(right, on=key_or_keys)
pd.merge(left, right, left_on=key_or_keys, right_index=True,
      how='left', sort=False)
result = left.join(right, on='key')
result = left.join(right, on=['key1', 'key2'])
result = left.join(right, on=['key1', 'key2'], how='inner')
4、concat
pd.concat(objs, axis=0, join='outer', join_axes=None, ignore_index=False,
          keys=None, levels=None, names=None, verify_integrity=False,
          copy=True)
objs︰ 一个序列或系列、 综合或面板对象的映射。如果字典中传递,将作为键参数,使用排序的键,除非它传递,在这种情况下的值将会选择 (见下文)。任何没有任何反对将默默地被丢弃,除非他们都没有在这种情况下将引发 ValueError。
axis: {0,1,…},默认值为 0。要连接沿轴。
join: {‘内部’、 ‘外’},默认 ‘外’。如何处理其他 axis(es) 上的索引。联盟内、 外的交叉口。
ignore_index︰ 布尔值、 默认 False。如果为 True,则不要串联轴上使用的索引值。由此产生的轴将标记 0,…,n-1。这是有用的如果你串联串联轴没有有意义的索引信息的对象。请注意在联接中仍然受到尊重的其他轴上的索引值。
join_axes︰ 索引对象的列表。具体的指标,用于其他 n-1 轴而不是执行内部/外部设置逻辑。
keys︰ 序列,默认为无。构建分层索引使用通过的键作为最外面的级别。如果多个级别获得通过,应包含元组。
levels︰ 列表的序列,默认为无。具体水平 (唯一值) 用于构建多重。否则,他们将推断钥匙。
names︰ 列表中,默认为无。由此产生的分层索引中的级的名称。
verify_integrity︰ 布尔值、 默认 False。检查是否新的串联的轴包含重复项。这可以是相对于实际数据串联非常昂贵。
副本︰ 布尔值、 默认 True。如果为 False,请不要,不必要地复制数据。